Claude Haiku 5.5:高量摘要便宜了,音视频链接仍要先变成文字

先说结论: 2026 年 10 月 7 日,Anthropic 发布 Claude Haiku 5.5。它是这一代里最便宜、最快的小模型,官方用途写的是高量摘要、压缩、分类、抽取,以及给更大模型当子代理。100k token 以内,输入 0.10 美元/百万 token,输出 0.50 美元/百万 token。公告没有把「一条视频链接」写成它的输入。
BibiGPT 的生产选择器里还没有这一项。下面不写「已经支持 Haiku 5.5」。要总结的是一条 B 站、YouTube 或播客链接时,仍然先把媒体拿下来、转成文字,再谈用哪一个文本模型做摘要。
目录
公告实际改了什么
Anthropic 的发布页把 Haiku 5.5 定义成高量、对成本敏感的小模型。它负责快而重复的活:摘要、压缩、数据库查询、分类。编码场景里,它可以作为 Opus 5.5 或 Sonnet 5.5 的子代理。官方还把它标成当时最快的模型,适合客服和浏览器操作这类对延迟敏感的任务。
模型卡上的标识是 claude-haiku-5-5。上下文窗口 100 万 token,最大输出 12.8 万 token。思考模式是自适应的,默认 effort 为 medium。开发者可以在 Claude Platform、Amazon Web Services、Google Cloud 和 Microsoft Foundry 上调用;Claude.ai 与 Claude Code 也能选到它。这些是托管 API 和产品里的入口,不是「把一个视频 URL 贴进去」。
SiliconANGLE 同日的报道把用途收成同一句话:高量摘要和分类是主要目标,编码团队可以把它当作更大模型派下来的子代理。报道同时写了 Sonnet 5.5 的缓存读取降价,那是另一条价格新闻,不要和 Haiku 的标价混成一张表。
实用规则: 先看公告列出的任务(摘要、分类、抽取、子代理)。公告没写的输入,不要脑补成已经支持。
价格表要看 100k 这一刀
官方把价格切在 10 万 token。Anthropic 说,上一代 Haiku 大约 90% 的请求落在这个长度以内。两档都按每百万 token 计:
| 项目 | Haiku 5.5,提示 ≤100k | Haiku 5.5,提示 >100k | Haiku 4.5 |
|---|---|---|---|
| 输入 | $0.10 | $0.50 | $1.00 |
| 输出 | $0.50 | $2.50 | $5.00 |
| 缓存读取 | $0.01 | $0.05 | $0.10 |
| 缓存写入 | $0.125 | $0.625 | $1.25 |
在 100k 以内,输入和输出的标价都是 Haiku 4.5 的 十分之一。超过 100k,输入 $0.50、输出 $2.50,相对 4.5 是半价,不是九折掉以后的「一律 1/10」。MarkTechPost 复述的也是这把刀,不是一个通栏的「全部打一折」。
平均节省官方写成大约 75%。原因写在模型卡里:Haiku 5.5 用了与 Claude 4.7 及之后模型相同的新分词器,同一段文字会比 Haiku 4.5 大约多出 30% 的 token。标价下降的幅度,大于账单下降的幅度。
实用规则: 报价时写明「100k 以内的输入/输出」。把 $0.10 / $0.50 说成所有长度的价格,会把长提示说便宜一倍。
它被写成用来做什么
发布页的用途清单是重复、量大、要快的文本活:
- 把已经到手的长文压成摘要
- 分类、抽取、路由
- 在智能体里做压缩,避免大模型反复读同一段上下文
- 作为子代理,接 Opus 或 Sonnet 派下来的小任务
- 客服和浏览器操作这类要低延迟的文本回合
这些活的共同点是:输入已经是文本,或是工具调用能返回的文本。 模型卡把同一句话写成 classification、extraction、routing。没有一条写成「上传一小时视频」或「粘贴一条播客链接」。
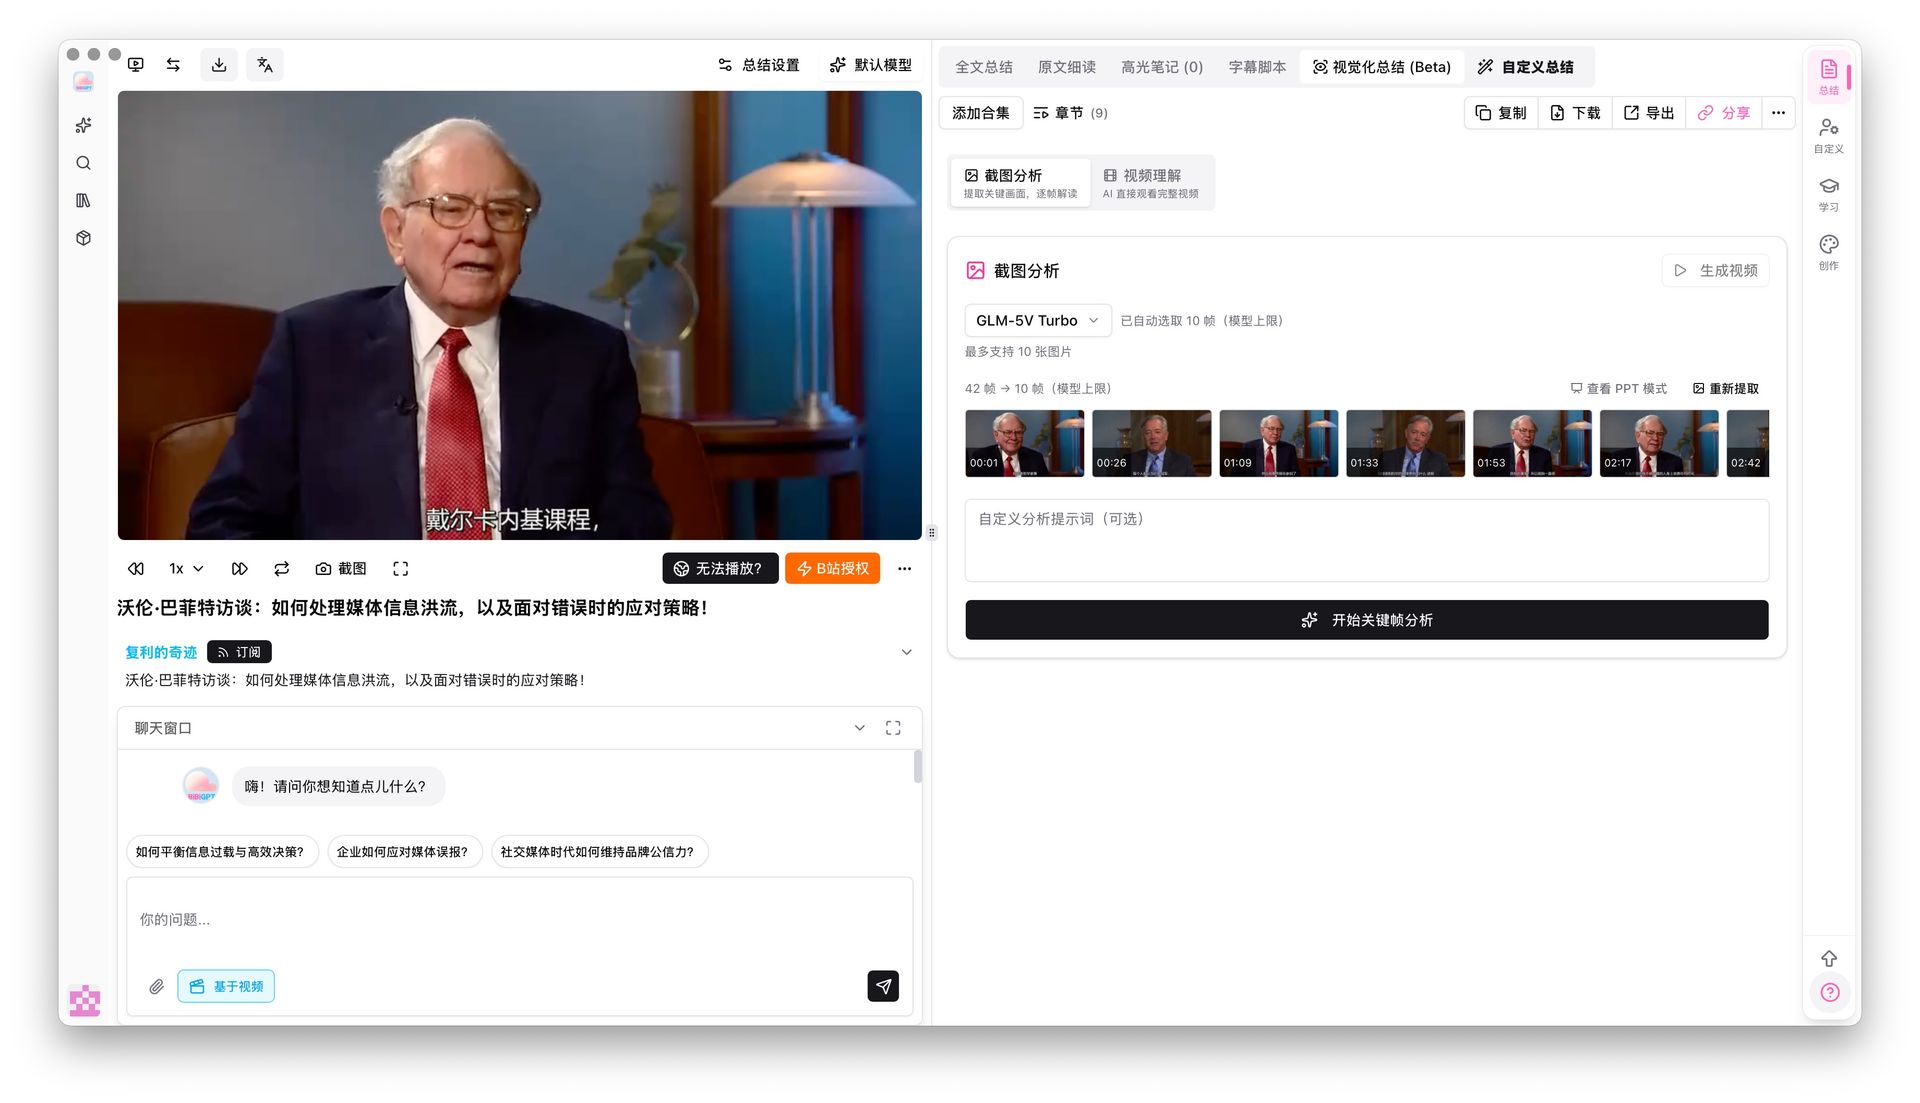
画面里的图表、板书、一闪而过的步骤,本来就不在纯文本摘要的输入里。要把它们写进笔记,得有一条会看关键帧的管线,而不是再换一个更便宜的聊天模型。
截图:BibiGPT · 关键帧画面分析。便宜的文本模型读不到这张图里的字,除非先有人把画面交给一条视频管线。
实用规则: 手里已经是文字,Haiku 5.5 的价目表才用得上。手里是一条链接,先解决拿媒体和转写。
音视频链接不在这条公告里
一条两小时的课,瓶颈通常不是「摘要这一步的标价」,而是视频下不下来、字幕对不齐、画面里的字没有进文本。Haiku 5.5 把摘要这一步的标价打下来,没有改掉前面几步。
BibiGPT 今天的路径仍是:粘贴链接,拿到带时间戳的章节、可搜索的字幕,再在已上线的模型里做总结。选择器里已经能用的模型,长这样:
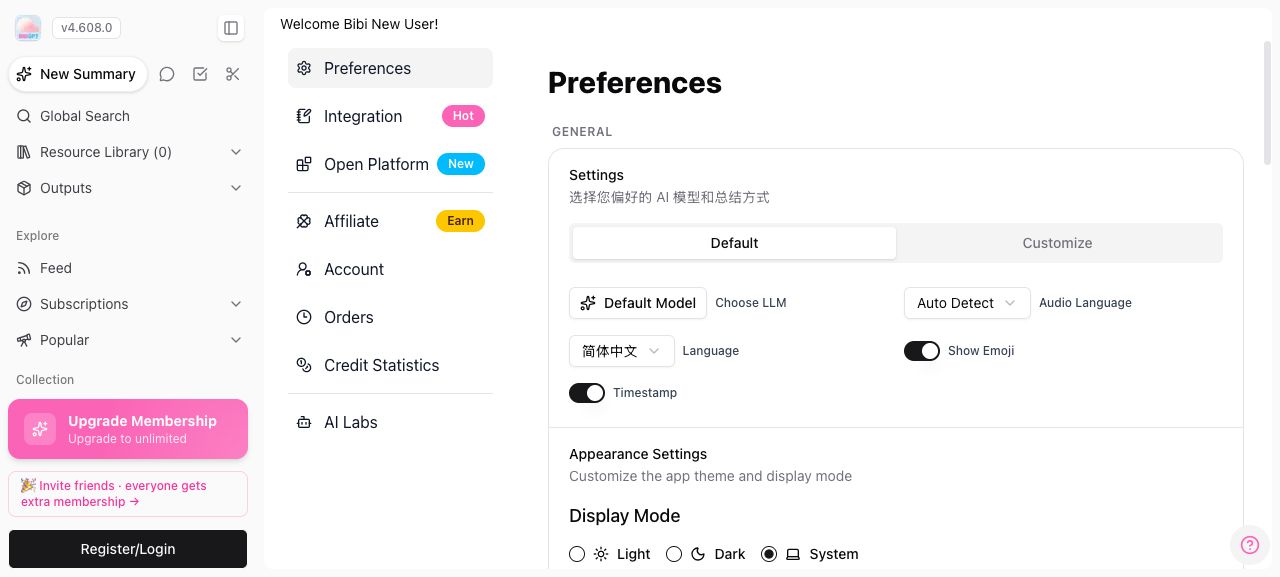
截图:BibiGPT · 偏好设置里的默认模型。Claude Haiku 5.5 在 2026-10-11 仍未部署到这个选择器,不要按这张图去搜它。
已上线的总结入口:
- AI 视频总结 — 粘贴链接,出章节要点
- 浏览器内免费视频总结 — 本地文件不上传
- YouTube 字幕提取 — 先拿到可搜索的文字
下面这段演示是「先粘链接」的形状。演示里的模型不是 Haiku 5.5。
几秒读完任何视频
选个样例,看 AI 总结——一句话结论、要点清单、可跳转的时间戳。
一句话: Karpathy 用代码从零搭出一个 GPT 风格的语言模型,逐行讲清每个部件——从最小的字符级模型到完整的 Transformer。
要点
- 先做一个 bigram 基线模型,再加自注意力,让 token 之间能"互相对话"
- 一个 Transformer 块 = 多头注意力 + 前馈网络 + 残差连接 + 层归一化
- 训练本质就是"预测下一个 token";剩下的交给规模和数据
- nanoGPT 背后的架构,放大后就是 ChatGPT
跳转
- 00:07 为什么要从零搭 GPT
- 08:23 直观理解自注意力
- 1:00:00 拼出 Transformer 块
- 1:35:00 从 nanoGPT 到 ChatGPT
演示:粘贴视频链接,得到带时间戳的章节要点。这一步不依赖 Haiku 5.5 是否上线。
视频:粘贴一条链接,得到带时间戳的要点。片中没有 Claude Haiku 5.5 的选择器。
实用规则: 看到「摘要便宜了」,先问输入是不是已经是文字。是文字,价目表才有意义。是链接,价目表还没开始。
什么时候用便宜的文本模型
| 你手上有什么 | 合适的下一步 | 不合适的下一步 |
|---|---|---|
| 已经整理好的会议纪要、论文 PDF 文本、客服对话 | 用高量小模型做摘要、分类、抽取 | 再开一条视频下载 |
| 一条视频或播客 URL | 先转写,必要时看关键帧 | 把 URL 丢进一个不接收该链接的聊天框 |
| 要在智能体里反复压缩同一段上下文 | Haiku 5.5 这种便宜、快的子代理 | 每次都把全文重新塞给最大的模型 |
| 希望 BibiGPT 今天就改用 Haiku 5.5 | 等它出现在生产选择器里 | 把「代码里有这个 id」写成「用户已经能选」 |
选择器截图里出现过的已部署模型,是另一篇文章的主角。Haiku 5.5 的模型 id 可以在代码或控制台里存在,同时生产页面仍匹配不到。探测失败或页面没有这个名字,就不要写接入稿。
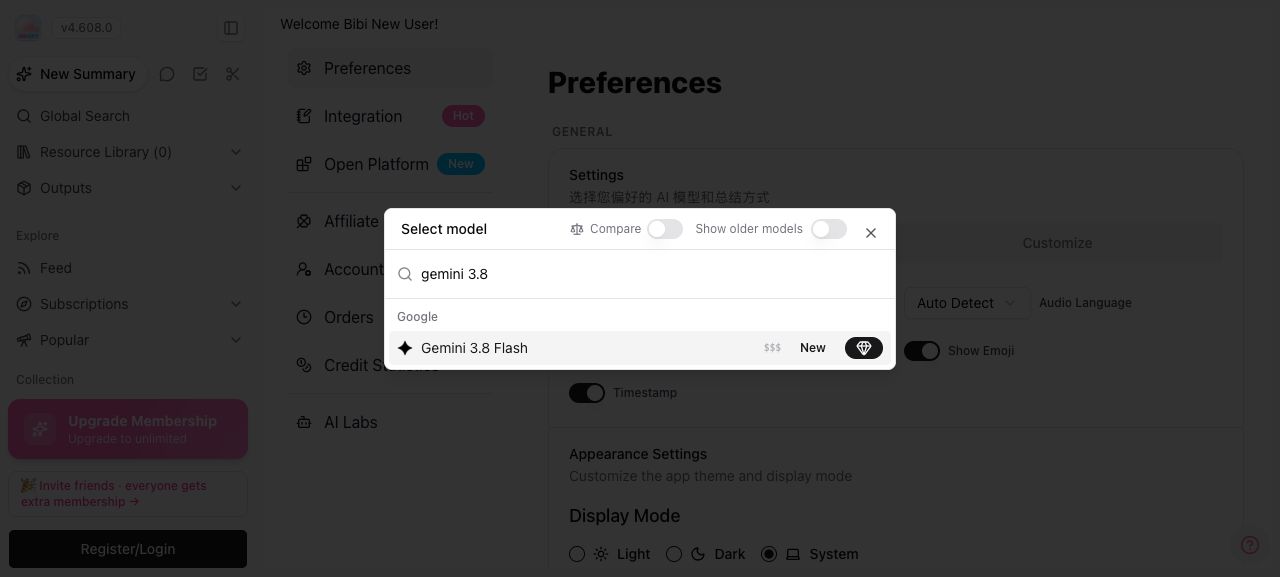
截图:BibiGPT · 已上线模型的选择器条目。用来说明「上线长什么样」,不是用来宣布 Haiku 5.5。
和 Haiku 4.5 比,别只看标价
三件容易说错的事:
- 标价 1/10 只覆盖 ≤100k 的输入和输出。 更长的提示是 $0.50 / $2.50,相对 4.5 大约是半价。
- 平均账单不是标价。 新分词器让同样的文字多出约 30% token,所以官方把平均节省写成大约 75%,而不是 90%。
- 缓存也分两档。 ≤100k 的缓存读取是 $0.01,不是「所有缓存都是 1 美分」。
Sonnet 5.5 缓存读取减半是同一天的另一条新闻。写进 Haiku 的对比表,会让两款模型的价都失真。
如果摘要的源是视频,省下的是「文字已经在手里之后」的那一次调用。转写、拉流、关键帧都不在 Haiku 5.5 的价目表里。
常见问题
BibiGPT 现在能选 Claude Haiku 5.5 吗?
不能。截至 2026-10-11,生产站点没有把它标成已上线的可选模型。本文不提供切换步骤。已上线的总结入口在 AI 视频总结。
为什么说它没有接住音视频链接?
因为 2026-10-07 的发布页和模型卡把用途写成摘要、分类、抽取、路由和子代理,没有把视频文件或视频 URL 写成输入。这是公告边界,不是对未来版本的预测。字幕已经抽出来之后,便宜的文本模型才进入流程。字幕入口见 YouTube 字幕提取。
$0.10 是不是所有请求的输入价?
不是。$0.10 / $0.50 是提示在 10 万 token 以内的输入和输出。更长的提示是 $0.50 / $2.50。再加上新分词器大约多 30% token,平均节省约 75%,不要把标价直接当成账单。
和「去原厂聊天」比,差在哪?
原厂适合你已经有文字的高量摘要。一条视频链接还要先被取下来、转写、必要时看画面。那条路径是 免费视频总结 这一类工具在做的事,不是 Haiku 5.5 价目表在做的事。
Popular tools
More in this series
- GPT-Transcribe vs Whisper vs Grok Voice 2.0 vs MAI-Transcribe:2026 语音转文字模型怎么选
- Apple iOS 27 Opens Third-Party AI: The Era of Switchable Assistants Is Here — How to Choose for Audio and Video (2026)
- DeepSeek R1 + BibiGPT: A Practical Guide to AI-Powered Audio/Video Understanding in 2025
- DeepSeek-V4 Hadir! BibiGPT Rilis Empat Model Baru + 1M Context di Hari Pertama — Ringkasan Video & Podcast AI Naik Level
- BibiGPT vs DeepSeek-V4 + Granite Speech Plus 2026: Self-Hosted Open Source vs Productized Stack
Lihat semua 7 artikel di Pembaruan Model →