DeepSeek V4.1 Flash 来了:BibiGPT 第一时间接入,音视频总结可在选择器里直接用(2026 年 9 月)

DeepSeek V4.1 Flash 来了:BibiGPT 第一时间接入,音视频总结可在选择器里直接用(2026 年 9 月)
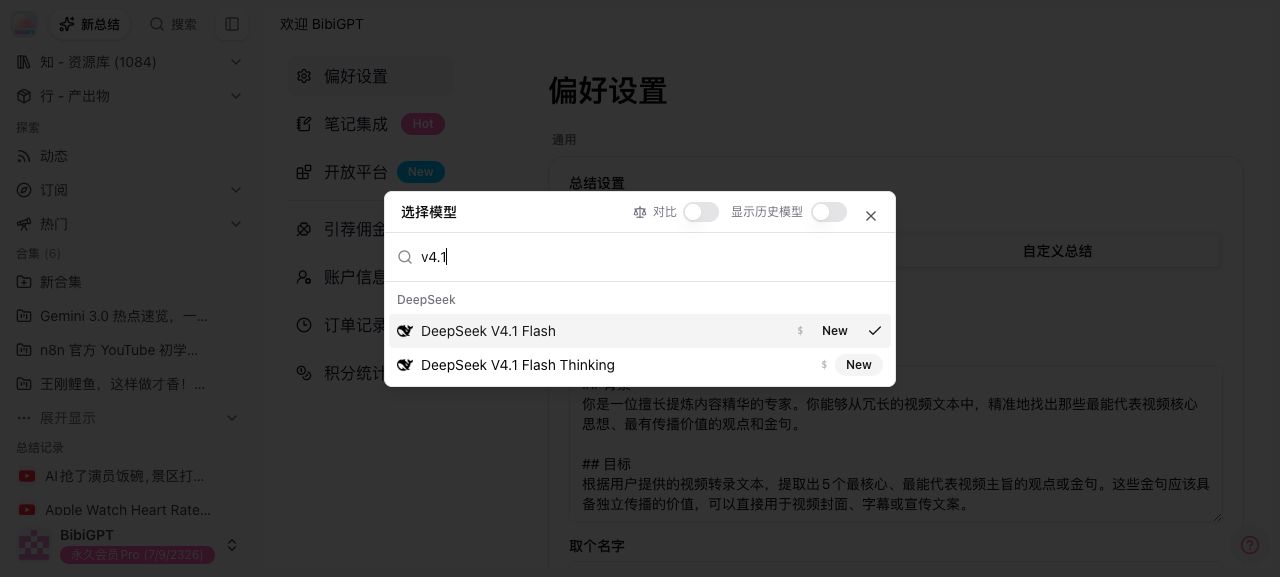
先说结论: 截至 2026 年 9 月 18 日,BibiGPT 已支持 DeepSeek V4.1 Flash。打开偏好设置里的默认模型,搜索 v4.1,就能看到带 New 标记的两条:Flash 与 Flash Thinking。它不是又一篇「V4 发布通稿」——这条链接要解决的是:新模型来了,怎么把它用在一条 B 站 / YouTube / 播客链接上,而不是先去 chat.deepseek.com 上传文件。
DeepSeek 在 2026 年 9 月 10 日发布 V4.1 Flash,定位是新结构系列里最小的一档,却带原生视觉。BibiGPT 在同一窗口完成接入。下面按「改了什么 → 接入哪一个 SKU → 为什么不直接去原厂 → 三步切换 → 适用场景」写完。
目录
- DeepSeek V4.1 Flash 这次改了什么
- 两个变体,BibiGPT 接入的是哪一个
- 为什么用 BibiGPT 的 V4.1 Flash,而不是直接去 chat.deepseek.com
- 三步切到 DeepSeek V4.1 Flash
- 这几个场景,切过去会立刻有感
- 模型不再稀缺,稀缺的是消费内容的速度
- 常见问题(FAQ)
DeepSeek V4.1 Flash 这次改了什么
据 DeepSeek 官方发布说明,V4.1 Flash 是新模型结构系列中最小尺寸的一档,具备原生多模态视觉理解。新结构的目标写得很直白:能力上限更高、推理更快、吞吐更大,并且还能扩到更大参数。
对音视频总结真正有用的,不是「又快了一代」这句话,而是规格表里能核对的几项。据同一篇发布说明与 DeepSeek 模型与价格页(截至 2026-09-18):
| 项 | 数字 / 能力 | 对总结意味着什么 |
|---|---|---|
| 总参数 / 激活 | 552B MoE;输入激活约 8B、输出激活约 16B | 小激活、大容量,长字幕不一定更贵 |
| 结构 | Causal-Encoder-Decoder,输入输出不对称 | 读长上下文相对便宜,写章节摘要仍够用 |
| 上下文窗口 | 1M token | 一场两小时访谈的字幕,不必先切成十几段再拼 |
| 输出上限 | 384K token | 章节摘要、要点、追问可以一次写完 |
| 输入模态 | 文本 + 图像理解 | 官方支持看图;BibiGPT 侧用关键帧,而不是整段视频塞进去 |
| 思考模式 | 非思考与思考(官方默认思考) | 短 Vlog 走 Flash,多观点长课走 Flash Thinking |
| 空闲价(每百万 token) | 缓存命中 0.02 元、未命中 1 元、输出 4 元 | 高峰为 2 倍;高峰是北京时间工作日 9:00–12:00、14:00–18:00 |
官方还写了两件容易和旧文搞混的事。第一,旧模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 对应的模型已下线,请求由 V4.1 Flash 承接。第二,9 月 10 日的发布说明曾计划:北京时间 9 月 14 日 12:00 之后,访问 deepseek-v4-pro 的请求转到 V4.1 Flash 并按 Flash 单价计费。截至 2026 年 9 月 18 日,价格页脚注已改为:9 月 14 日之后继续提供 V4 Pro 的 API,计费方式保持不变。不要把「原厂一度计划下线」写成「现在已经不能选」。
权重与技术报告在 Hugging Face 的 DeepSeek-V4.1-Flash 仓库。这些数字衡量的是官方 API 规格,不是「视频总结准确率」。不要把参数表直接翻译成「总结更好」——总结好不好,卡点往往在字幕拿取和关键帧,不在 MoE 激活数。
实用规则: 读新模型发布,先把「官方规格」和「音视频工作流」拆开。前者告诉你模型更会规划,后者才决定你能不能把一条链接变成带时间戳的笔记。
两个变体,BibiGPT 接入的是哪一个
同一代 Flash 在选择器里是两行,不是一行里的开关。截至 2026 年 9 月 18 日,生产选择器搜索 v4.1 会命中这两条,都带 New,算力消耗均为「省」,都没有 (pro) 标记:
| 变体 | 定位 | 谁能用 | BibiGPT 选择器 |
|---|---|---|---|
| DeepSeek V4.1 Flash | 非思考档,快读长字幕、出章节 | DeepSeek API(deepseek-flash) | ✅ 已上线,标签为 DeepSeek V4.1 Flash (new) |
| DeepSeek V4.1 Flash Thinking | 思考档,多步推理、观点对照 | 同一官方模型的思考模式 | ✅ 已上线,标签为 DeepSeek V4.1 Flash Thinking (new) |
| DeepSeek V4 Pro / Pro Thinking | 上一代旗舰 | 官方 API 仍提供 | 仍可选用,无 New |
| DeepSeek V4 Flash / Flash Thinking / Vision Exp | 上一代 Flash 与视觉实验档 | 官方旧名已由 V4.1 Flash 承接 | 仍可选用,无 New |
不要把「支持 DeepSeek V4.1 Flash」读成「每一条视频都自动走它」——它在列表里,你选中才用。也不要写成「全系列已接入新结构」:上一代 V4 还在,只是去掉了 New。
打开偏好设置,点默认模型,搜索 v4.1,目前会命中上面两行。这就是接入完成的收据:
截图:BibiGPT · 模型选择器,DeepSeek V4.1 Flash 与 Flash Thinking 均带 New,算力消耗为省。
实用规则: 原厂发两个 SKU 时,先问「哪一个会出现在我每天点的那个下拉框里」。出现了,才叫接入;没出现的那个,写进文章当背景即可,不要假装用户也能选。
为什么用 BibiGPT 的 V4.1 Flash,而不是直接去 chat.deepseek.com
这是这篇接入文最该回答的问题。chat.deepseek.com 和 DeepSeek API 都能跑 V4.1 Flash。为什么还要在 BibiGPT 里选它?
因为原厂给你的是模型,音视频总结缺的是输入层:
B 站 / YouTube / 播客 / 本地文件
        │
        ▼
  拿字幕或转写音频 + 抽关键帧
        │
        ▼
  把整理好的材料交给你选的模型
  (今天可以是 DeepSeek V4.1 Flash)
        │
        ├── 带时间戳的章节摘要
        ├── 可跳转的字幕
        └── 思维导图 / 追问 / 导出
直接去原厂聊天框,你得先自己把视频下下来、切好、传上去。一条两小时的视频动辄几个 GB;B 站、抖音、小红书各有各的拿取方式。模型再聪明,也接不住「剪贴板里的那条链接」。
BibiGPT 已经服务超过 100 万用户、累计生成超过 500 万次 AI 总结,覆盖 YouTube、B 站、抖音、TikTok、小红书、播客等 30+ 平台。新模型叠在这条管线上,继承的是「粘贴链接 → 结构化笔记」,不是从空白对话框开始。相关能力页:
- AI 视频总结 — 粘链接出章节要点
- B 站视频总结 — 国内平台链接不用先下载
- 浏览器内免费视频总结 — 本地文件不上传
- YouTube 字幕提取 — 先拿可搜索的文字,再决定要不要总结
- 播客总结 — 长音频同样走这条输入层
下面这个演示是同一条路径的形状——先粘链接,再谈模型:
几秒读完任何视频
选个样例,看 AI 总结——一句话结论、要点清单、可跳转的时间戳。
一句话: Karpathy 用代码从零搭出一个 GPT 风格的语言模型,逐行讲清每个部件——从最小的字符级模型到完整的 Transformer。
要点
- 先做一个 bigram 基线模型,再加自注意力,让 token 之间能"互相对话"
- 一个 Transformer 块 = 多头注意力 + 前馈网络 + 残差连接 + 层归一化
- 训练本质就是"预测下一个 token";剩下的交给规模和数据
- nanoGPT 背后的架构,放大后就是 ChatGPT
跳转
- 00:07 为什么要从零搭 GPT
- 08:23 直观理解自注意力
- 1:00:00 拼出 Transformer 块
- 1:35:00 从 nanoGPT 到 ChatGPT
演示:粘贴视频链接,得到带时间戳的章节要点。DeepSeek V4.1 Flash 是这条路径上可选的模型,不是替代这条路径。
想看完整操作,而不是另一份规格表,可以先看这段产品演示:
视频:粘贴一条链接,得到带时间戳的要点、思维导图和可追问的问答。
画面里的图表、板书、一闪而过的操作步骤,只存在于关键帧,不在语音里。通用聊天框很容易漏;专门对关键帧做画面分析,才会把这些信息写进总结:
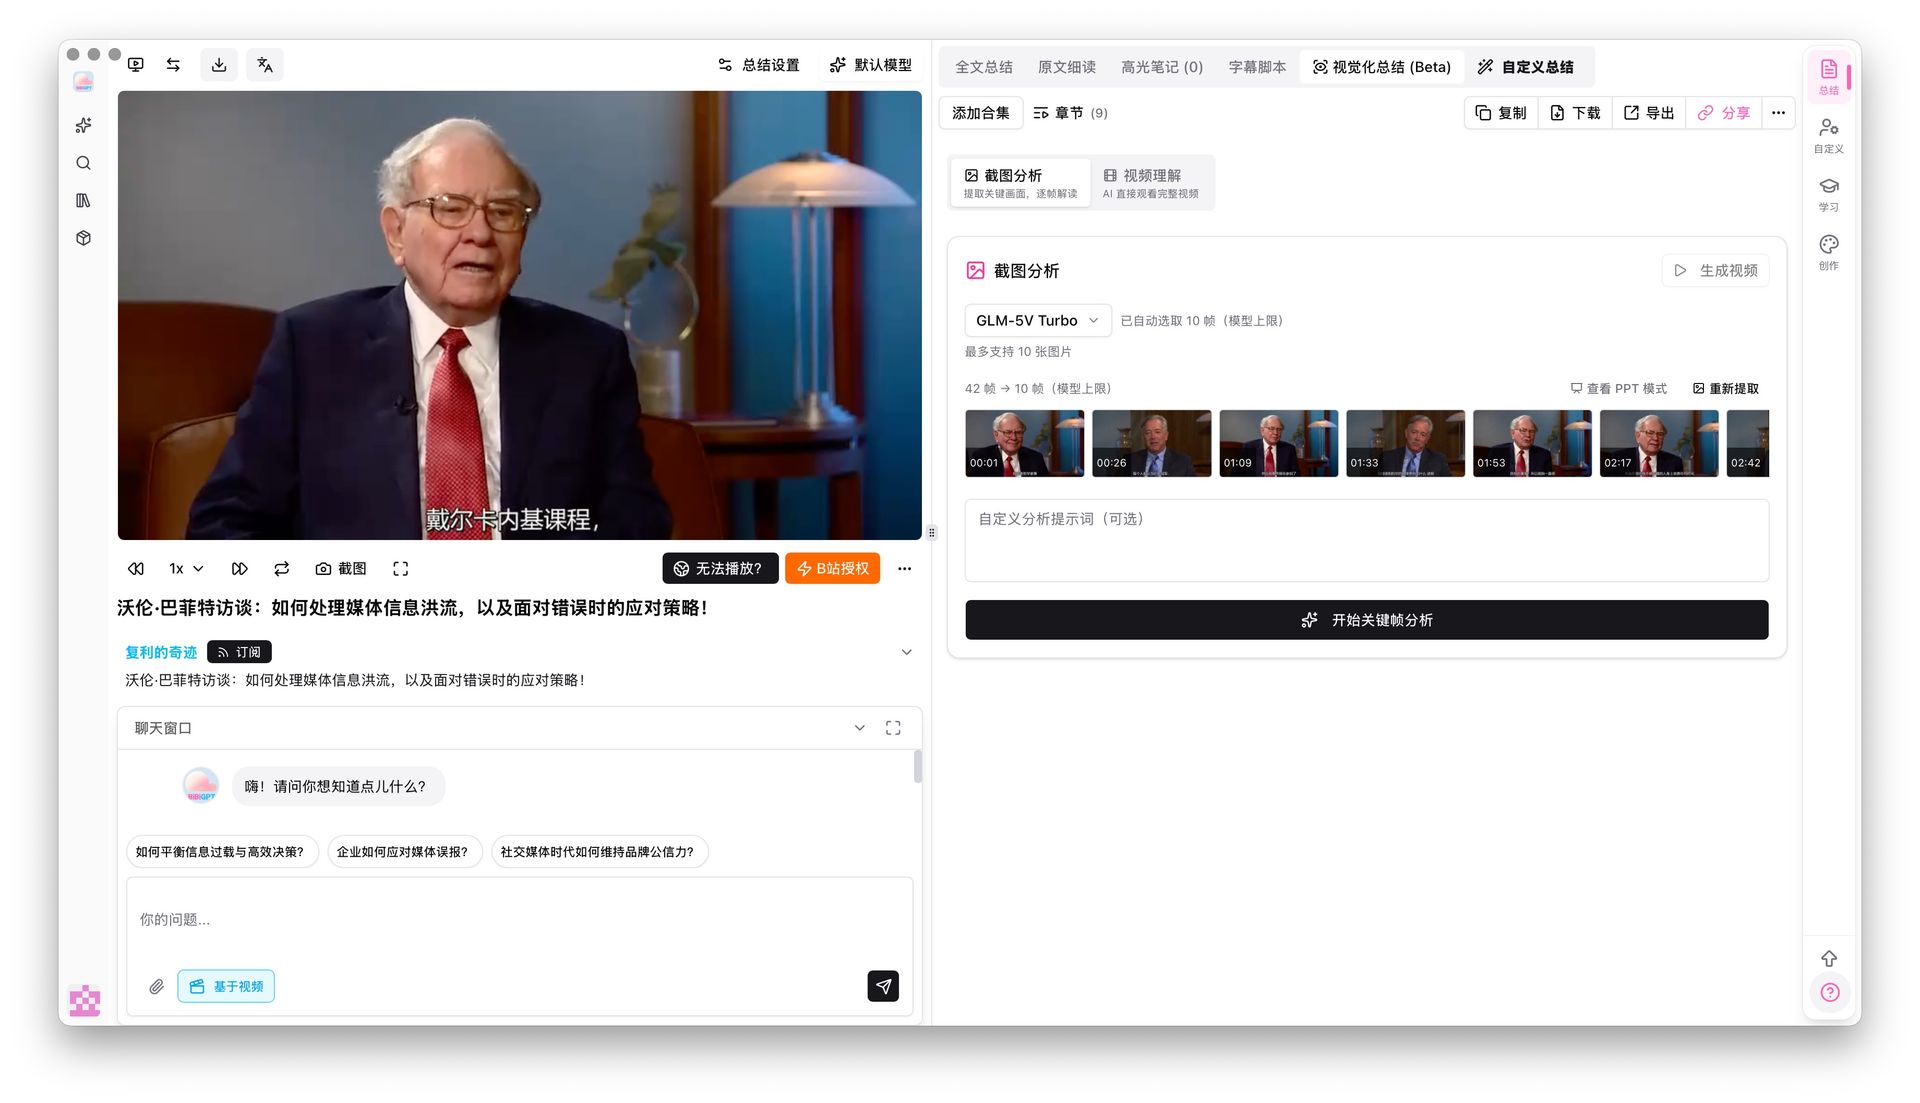
截图:BibiGPT · 关键帧画面分析。模型不只听声音,还会看画面里的字。
实用规则: 模型变便宜、变聪明,不会吃掉总结工具;它把胜负手从「算力成本」挪到了「输入层」。打不开你要看的那条视频,总结再漂亮也是零分。
三步切到 DeepSeek V4.1 Flash
入口就在偏好设置,不需要等一次总结跑完再找。
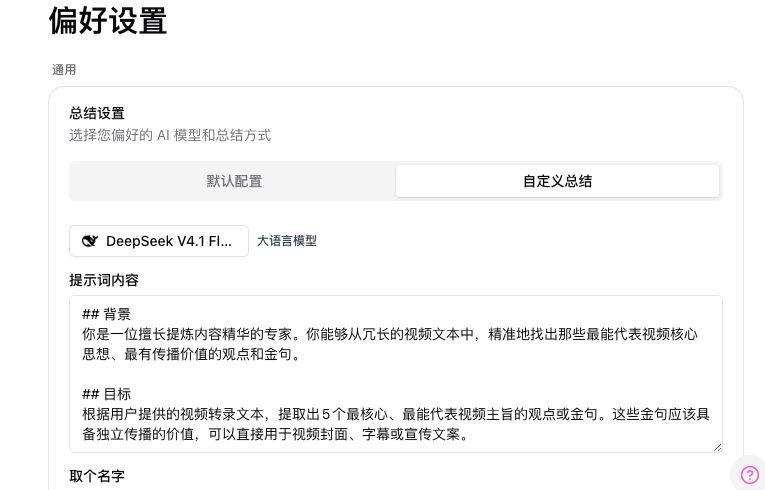
截图:BibiGPT · 偏好设置,默认模型是切换入口。
- 打开 BibiGPT,把 YouTube / B 站 / 播客链接贴进输入框,或先进入偏好设置。
- 点击默认模型,在搜索框输入
v4.1。 - 选中 DeepSeek V4.1 Flash(New,算力消耗:省),回到输入框点「一键总结」。需要多步对照时,改选 Flash Thinking。
选好的模型会保留到下一次。短内容不必强行切;长访谈、多观点对谈、需要分步推理的课,再把它打开。
上一档 DeepSeek 的手感,可以对照 DeepSeek V4 四款模型与 1M 上下文接入。那篇写的是 2026 年 4 月的 V4 预览代,不是今天的 V4.1 Flash。若你要的是「实验视觉档怎么看画面」而不是「选择器里的新 Flash」,走的是另一篇文章:DeepSeek V4 Flash Vision Exp 视频理解。不要把 V4.1 Flash、V4 1M 通稿、Vision-Exp 评测当成同一篇。
实用规则: 切换模型最多三步。第四步开始,就是在找借口——入口不在发布会海报上,在选择器里。
这几个场景,切过去会立刻有感
不是所有视频都值得换成 V4.1 Flash。算力消耗为「省」的档,留给「字幕很长、还要看画面」的内容:
- 两小时以上的发布会、财报电话会、长访谈。 1M 上下文让整场字幕可以一次喂进去,减少「分段再拼接」带来的前后矛盾。
- 课上有板书、图表、演示操作的录像。 官方图像理解 + 关键帧分析,比只听语音更不容易漏掉画面信息。
- 需要追问、对比观点、写出可执行下一步的内容。 思考档用在「这段讲了什么」之后的「所以我该做什么」。
- 同一条视频要出摘要、思维导图、可跳转字幕。 模型负责理解;导出和跳转是产品层已经接好的。
同一份总结换成可复习的形态,是思维导图,不是再生成一段白文:
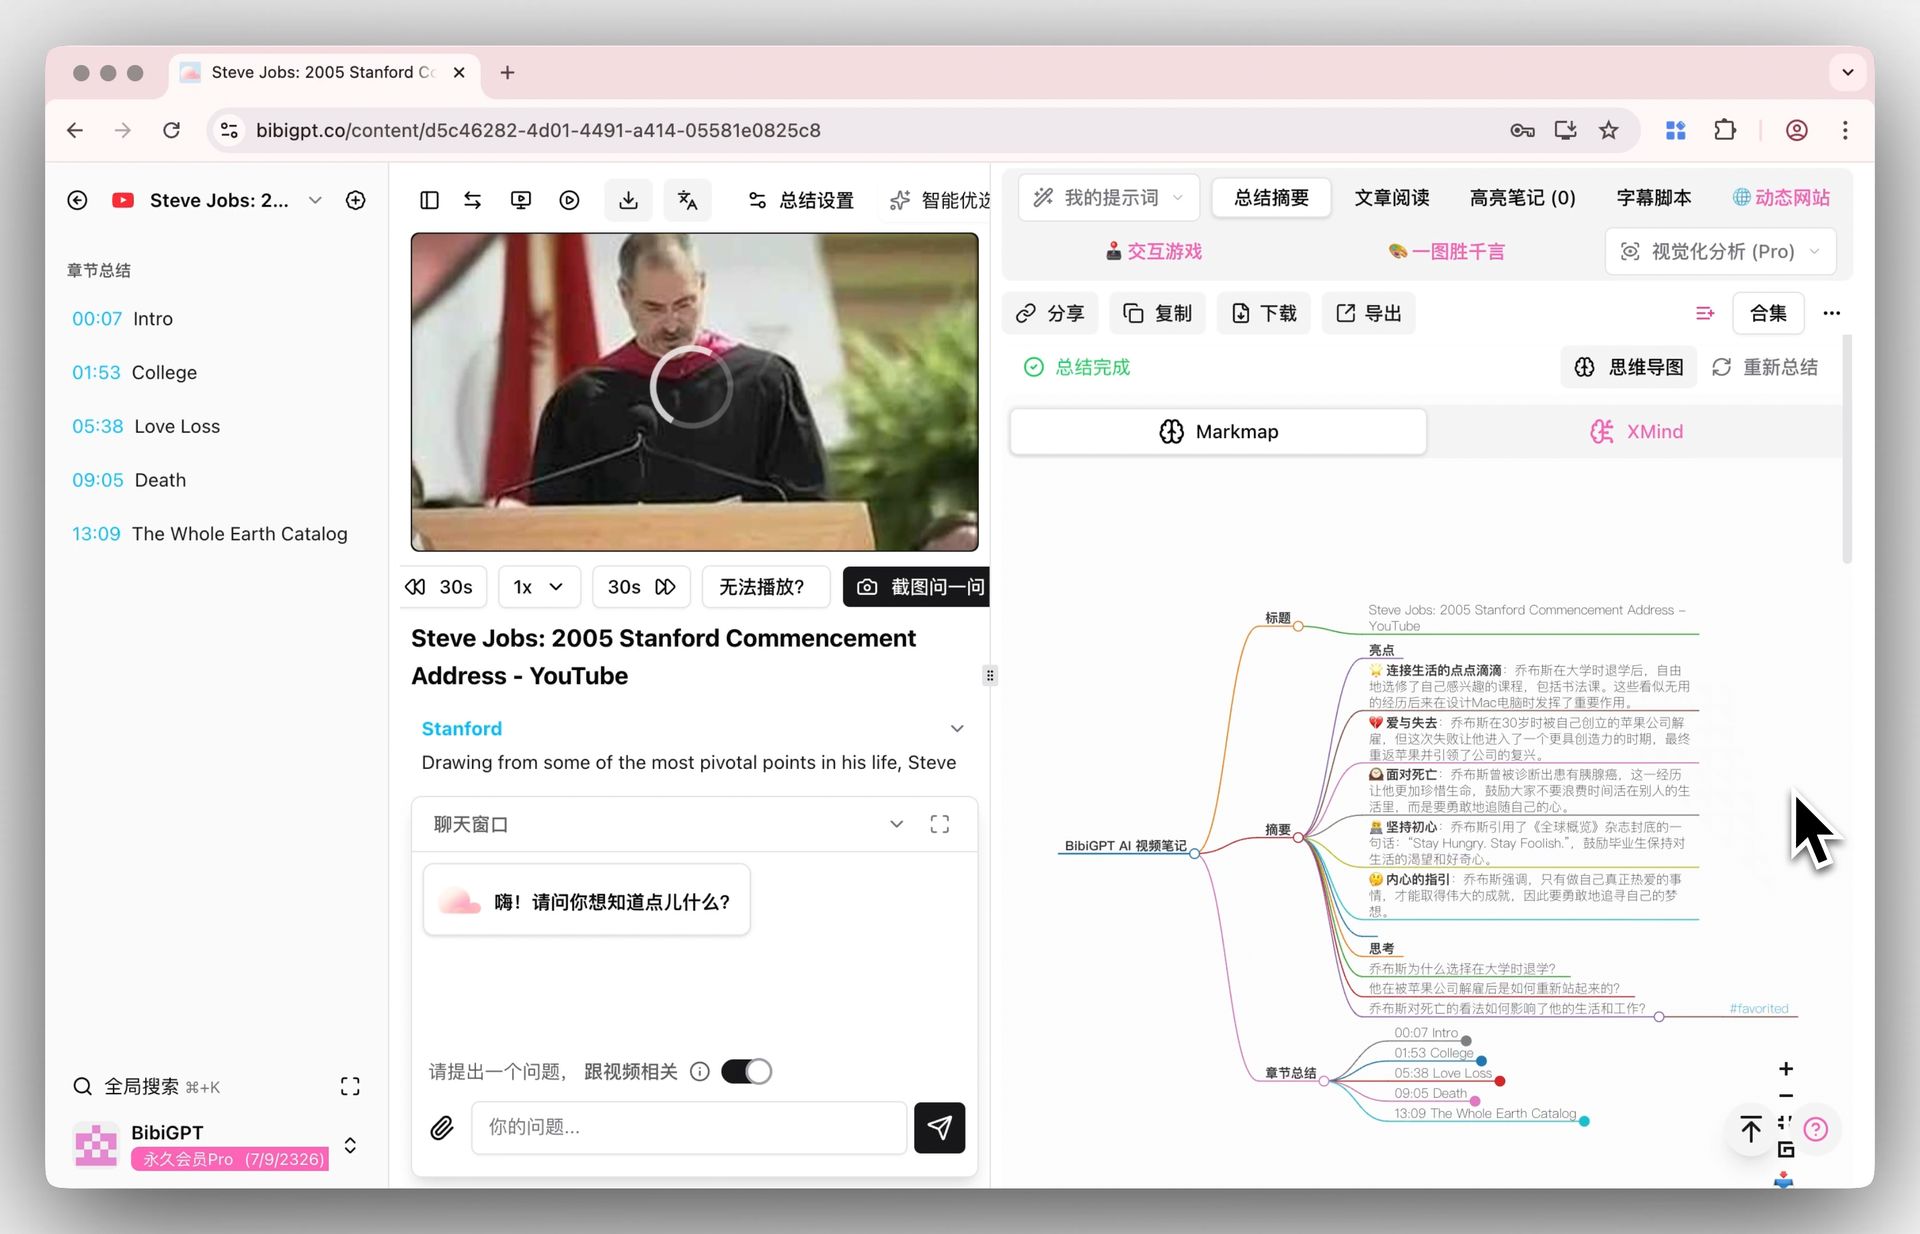
截图:BibiGPT · 视频要点生成思维导图,节点可点回原片对应时间。
短 Vlog、已经有官方字幕的通稿、只想抽三句话的新闻,用更轻的模型就够。把 V4.1 Flash 留给「看完要做事」的那一类。
模型不再稀缺,稀缺的是消费内容的速度
Flash 线还在按周迭代。再过一个季度,选择器里会出现 V4.1 Pro 或别的名字。这不是坏事:模型不再是护城河,把一条还没看的视频变成能搜索、能跳转、能追问的文本,才是每天要重复的动作。
BibiGPT 不是另一个模型聚合器。它在模型前面补字幕和关键帧,在模型后面补时间戳、导图、导出和合集。100 万用户、500 万次总结、30+ 平台,说的是这条管线已经被走通,而不是某个模型「由谁驱动」。
可打脸预判:到 2027 年 3 月 1 日,如果音视频总结产品的主战场仍然是「谁家模型参数更大」,而不是「谁能稳定打开你剪贴板里的那条链接」,上面这句判断作废。
想当天就试:打开 BibiGPT 桌面,把一条你本来打算「回头再看」的链接贴进去,在默认模型里选 DeepSeek V4.1 Flash。
常见问题(FAQ)
BibiGPT 支持 DeepSeek V4.1 Flash 了吗?
支持。截至 2026 年 9 月 18 日,模型选择器里可以搜到 DeepSeek V4.1 Flash (new),算力消耗为「省」。它不会自动套到每一条视频上,需要你选中。入口在 偏好设置。
为什么不直接去 chat.deepseek.com / 原厂 App / 原厂 API?
原厂给你模型和聊天框。一条 B 站或 YouTube 链接要先变成音频和关键帧,才能交给模型;总结之后还要时间戳、导图和导出。BibiGPT 补的是这一层,不是再包一层聊天。可先看 AI 视频总结。
Flash Thinking 也能选吗?
能。截至 2026 年 9 月 18 日,搜索 v4.1 会同时命中 Flash 与 Flash Thinking,两条都带 New。短内容用 Flash;需要对观点、写下一步时再切 Thinking。不要和 2026 年 4 月那篇 V4 1M 上下文接入文 里的 V4 Thinking 混成一代。
免费用户能用吗?
选择器里这两条没有 (pro) 标记,额度消耗为「省」。免费档可以先在列表里找到它们再试;若你的账号看不到,先确认走的是国内产品路线,而不是海外选择器。
它和 DeepSeek V4 Flash Vision Exp 有什么区别?
V4.1 Flash 是 2026-09-10 的新结构正式版,官方带图像理解。Vision Exp 是上一代视觉实验档,BibiGPT 选择器里仍保留,但官方旧名已由 V4.1 Flash 承接。要看实验视觉档的评测,读 Vision Exp 视频理解,不要把两篇当成同一切口。
Popular tools
本系列更多文章
- AI Competitive Intelligence Workflow: Build Industry Monitoring with BibiGPT Video Summaries
- Lessons From Shipping BiliGPT: Two Cold-Start Growth Tactics Behind a GPT-3 Side Project
- [BibiGPT Growth Series] Episode 1 | How AI Summaries for Bilibili Were Born
- BibiGPT Advanced Guide 2026: Download + AI-Summarize Videos from WeChat Channels, RedNote, TikTok, and Enterprise Intranet Sites
- Chat with Any Video: How to Ask AI Questions About Videos Instead of Watching the Whole Thing (2026)