
什么是原生全模态模型?
原生全模态模型在同一套栈里吃多种介质——这里是文本、图像、音频和视频——再写出一份文本回复。它不是「先语音识别、再文本模型」的串联。文档里 Qwen3.8-Omni-Flash 就是这类栈。
截至 2026-09-26:阿里通义千问团队于 2026-09-18 发布 Qwen3.8-Omni-Flash——原生全模态(文本/图像/音频/视频进、文本出),上下文 1M。要从会议或长视频拿章节,粘链接就行——不必自己接全模态接口。
Paste a long-form video or meeting URL — BibiGPT turns it into chapters, a transcript, and follow-up Q&A.
截至 2026-09-26:阿里通义千问团队于 2026-09-18 发布 Qwen3.8-Omni-Flash——原生全模态(文本/图像/音频/视频→文本),1M 上下文,相对 Qwen3.5-Omni-Plus 在 30 项评测上平均 +26%。最近更新:2026-09-26。
2026-09-18,通义千问团队发布 Qwen3.8-Omni-Flash:一套原生全模态模型,同时吃文本、图像、音频和视频,只吐文本。已在 Qwen AI 与阿里云百炼上线。这不是 2026-08-26 那版文本 Flash-Next 权重。
Qwen 称同一套模型接受文本、图像、音频和视频,再写出文本。这与 Qwen3.8-Flash(文本多模态 MoE)和 Qwen3-ASR(只做语音识别)不是同一类产品。
文档里的上下文窗口是一百万单位,最长输出 131K。长会议文字稿可以一次装下。宽窗口本身不会帮你归档章节和时间戳。
Qwen 称在 30 项评测上平均比 Qwen3.5-Omni-Plus 高 26%,AliMeeting DER / cpWER 从 88.11 / 89.61 降到 3.35 / 17.18。这是厂商分数,不是 BibiGPT 跑的测试。
更便宜的全模态接口,帮的是已经在接阿里云的团队。它本身不会给学生从两小时 B 站上传或一场站会录音里直接吐出带时间戳的笔记。后半截活是 BibiGPT 的产品位。
粘一条链接,拿到章节、文字稿和后续问答。BibiGPT 支持用 Qwen3.8 Omni Flash 做长内容笔记——你不用去挑全模态配方。
音频和视频能进模型,很有用。九十分钟会议仍然需要时间戳和导出。一次便宜的接口调用却从不归档,等于白费;带章节的总结才是下周还能搜到的文档。
Qwen3.8-Flash 是 8 月那版文本 / 多模态 MoE。Gemini 3.8 Flash 是同期谷歌在音视频任务上的对照。Qwen3-ASR 是语音识别。本页只讲 2026-09-18 的 Omni-Flash 事件。一种意图,一个 URL。
来自 Qwen 2026-09-18 Qwen3.8-Omni-Flash 发布的核心事实。
Qwen 当天在 Qwen AI 与阿里云百炼发布 Qwen3.8-Omni-Flash(接口名 qwen3.8-omni-flash)。这是托管全模态 SKU,不是开源 Flash-Next 权重投放。
一套模型接受四种输入、写出文本。这与 Qwen3.8-Flash(文本多模态 MoE)和 Qwen3-ASR(语音识别)不是同一类活。
Qwen 文档写明一百万单位窗口。LiteLLM 同日说明列出最长输出 131K。长会议一次能装下;调用之后仍然需要章节。
Qwen 称 30 项评测平均 +26%,AliMeeting DER/cpWER 88.11/89.61 → 3.35/17.18,音视频分数接近 Gemini 3.8 Flash。厂商数字,这里转述。
LiteLLM 列出输入 0.15 美元、缓存 0.016 美元、输出 0.47 美元,视频输入大约比 Qwen3.5-Omni-Plus 便宜 89%。做预算前请到百炼核对。
原生全模态 Qwen SKU 哪里重要——以及总结器才是真正的产品位。
在自己的栈里用 Qwen3.8-Omni-Flash 做全模态理解。然后再把讲完的课或站会粘进 BibiGPT,让人拿到章节,而不是一坨生文本。
两小时 B 站上传或一场站会录音,不需要一份全模态接口简报。粘 URL、导出文字稿、继续追问。这就是 BibiGPT 的路径。
Qwen3.8-Flash 是 8 月文本 MoE。Qwen3-ASR 是语音识别。Gemini 3.8 Flash 是谷歌音视频对照。本页只讲 Omni-Flash。一个模型家族事件,一个 URL。
与这次发布配套的会议与长视频笔记工作流。
本页规格来自 Qwen 2026-09-18 公告与 LiteLLM 同周日说明。
Qwen 于 2026-09-18 发布 Qwen3.8-Omni-Flash:原生全模态(文本/图像/音频/视频→文本)、1M 上下文,已在 Qwen AI 与阿里云百炼上线。Qwen 称相对 Qwen3.5-Omni-Plus 在 30 项评测平均 +26%,AliMeeting DER/cpWER 88.11/89.61 → 3.35/17.18。
Qwen — Qwen3.8-Omni-Flash ↗LiteLLM 2026-09-18 同日说明列出接口名 qwen3.8-omni-flash、1M 上下文、最长输出 131K、国际标价每百万单位输入 0.15 / 缓存 0.016 / 输出 0.47 美元,以及视频输入大约比 Qwen3.5-Omni-Plus 便宜 89%。
LiteLLM — Qwen3.8-Omni-Flash day-0 ↗原生全模态模型在同一套栈里吃多种介质——这里是文本、图像、音频和视频——再写出一份文本回复。它不是「先语音识别、再文本模型」的串联。文档里 Qwen3.8-Omni-Flash 就是这类栈。
一百万单位的窗口原则上能在一次调用里装下长文字稿加指令。它本身不会产出章节、时间戳,或下周还能搜到的导出件。那些产物是笔记产品该干的活。
看看大家为什么每天都用 BibiGPT 把视频转成文字。
全球 50,000+ 用户的信赖之选
“贴上链接几秒钟就拿到干净的字幕文字,每周帮我省下好几个小时的手动整理时间。”
Maya R.
内容创作者 · 二次创作短视频
“导出逐字稿后我可以按自己的节奏复习生词,再也不用反复暂停视频了。”
Daniel K.
语言学习者 · 用真实视频学外语
“准确、带时间戳的文字可以直接引用,它已经悄悄成为我日常工作流的一部分。”
Priya S.
研究人员 · 引用公开演讲
常见问题
有问题?问我们!
 1
给 DeepSeek Harness 装视频总结 skill 只需拷贝目录——SKILL.md 和 Claude Code 通用。也可以不装 dsh:在浏览器里粘贴 B 站或 YouTube 链接,直接出带时间戳的总结。
 2
2026年B站AI视频总结工具哪个最好?粘贴任意链接,几秒生成结构化总结、思维导图和重点提炼,支持30+平台、免登录。文末对比5大工具,选出最适合你的那一个。
 3
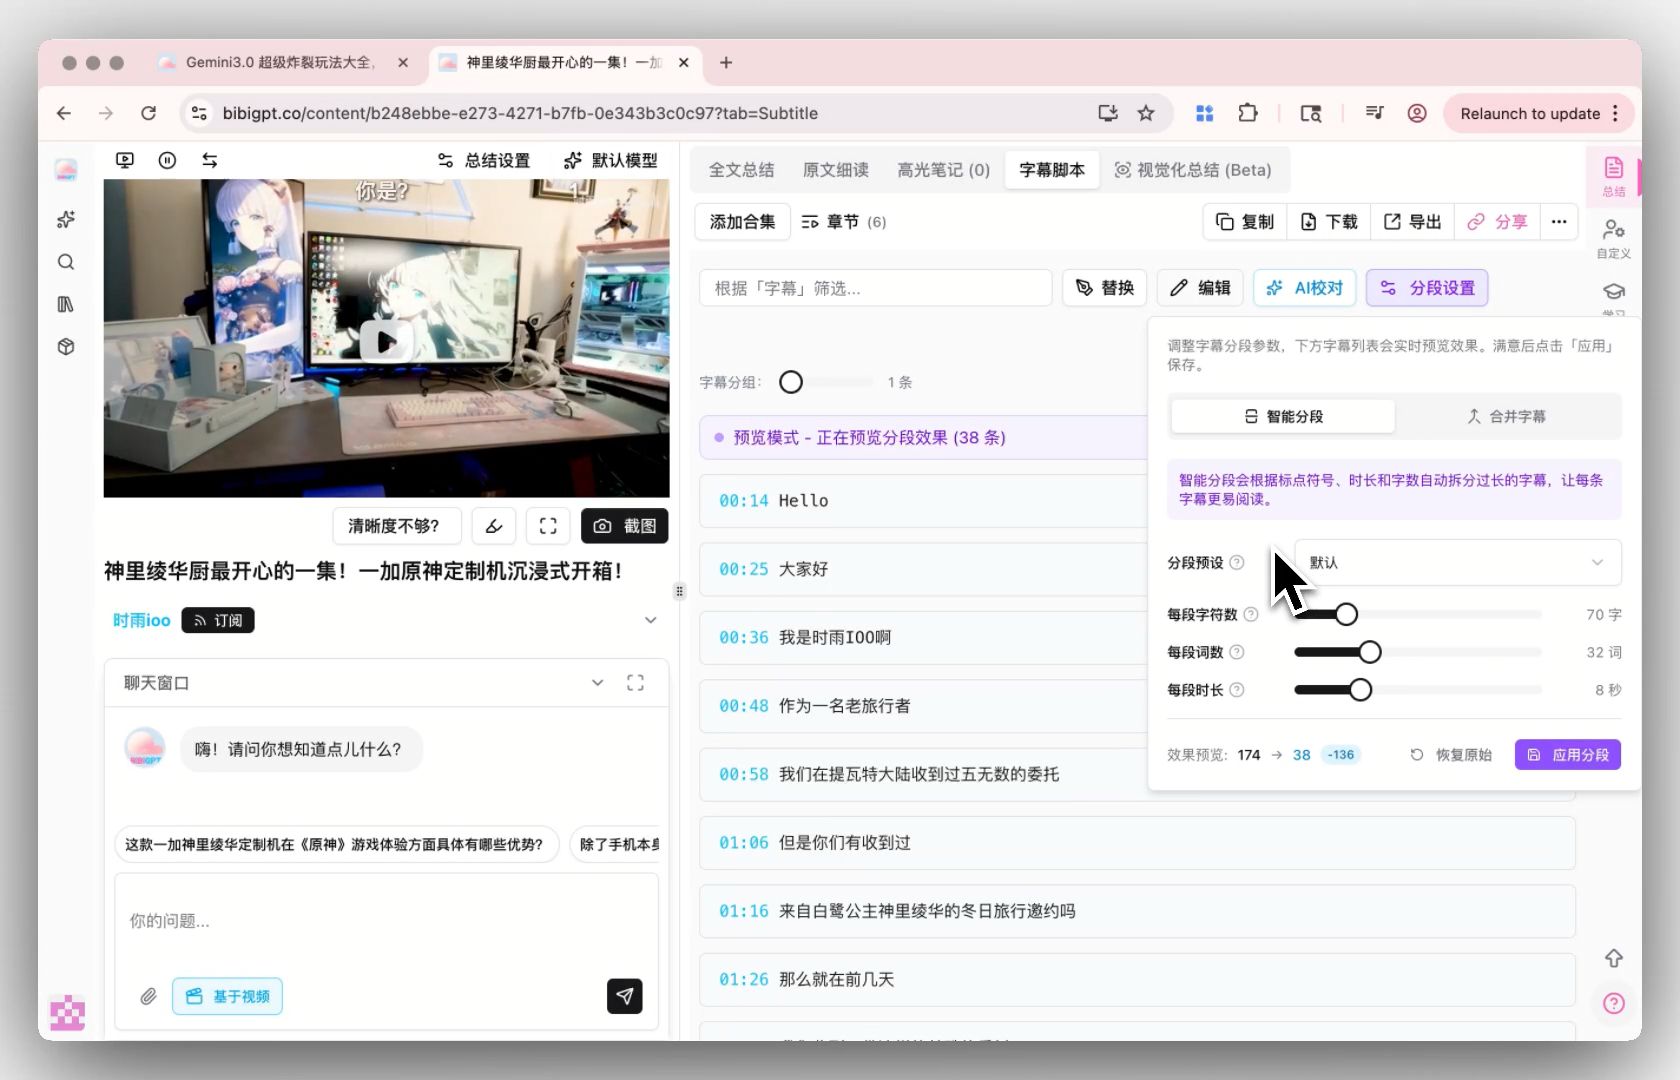
海外用户如何提取B站视频字幕?2026 更新版横向对比5款主流bilibili transcript工具,从字幕提取、AI总结到格式导出全面评测,看BibiGPT如何凭借原生B站支持脱颖而出。