
네이티브 옴니 모델이란?
네이티브 옴니 모델은 같은 스택 안에서 여러 매체 — 여기서는 텍스트·이미지·오디오·영상 — 를 받아 하나의 텍스트 응답을 씁니다. 「먼저 ASR, 그다음 텍스트 모델」 직렬이 아닙니다. 문서상 Qwen3.8-Omni-Flash가 이런 스택입니다.
2026-09-26 기준, Alibaba Qwen 팀은 2026-09-18에 Qwen3.8-Omni-Flash를 공개했습니다 — 네이티브 옴니(텍스트/이미지/오디오/영상 입력, 텍스트 출력), 컨텍스트 1M. 회의나 장편 영상에서 챕터가 필요하면 링크만 붙이면 됩니다 — 옴니 API를 직접 붙일 필요는 없습니다.
Paste a long-form video or meeting URL — BibiGPT turns it into chapters, a transcript, and follow-up Q&A.
2026-09-26 기준, Alibaba Qwen 팀은 2026-09-18에 Qwen3.8-Omni-Flash를 공개 — 네이티브 옴니(텍스트/이미지/오디오/영상→텍스트), 1M 컨텍스트, Qwen3.5-Omni-Plus 대비 30개 벤치 평균 +26%. 최종 업데이트: 2026-09-26.
2026-09-18 Qwen 팀이 Qwen3.8-Omni-Flash를 공개했습니다: 텍스트·이미지·오디오·영상을 동시에 받고 텍스트만 내는 네이티브 옴니 모델입니다. Qwen AI와 Alibaba Cloud Model Studio에서 이용할 수 있습니다. 2026-08-26 텍스트 Flash-Next 가중치와는 별개입니다.
Qwen에 따르면 동일 스택이 텍스트·이미지·오디오·영상을 받아 텍스트를 씁니다. Qwen3.8-Flash(텍스트 멀티모달 MoE)나 Qwen3-ASR(음성 인식 전용)과는 다른 카테고리입니다.
문서상 컨텍스트 창은 100만 단위, 최대 출력은 131K입니다. 긴 회의 대본을 한 번에 넣을 수 있습니다. 넓은 창만으로는 챕터·타임스탬프가 자동으로 생기지 않습니다.
Qwen은 30개 벤치에서 Qwen3.5-Omni-Plus 대비 평균 +26%, AliMeeting DER/cpWER가 88.11/89.61에서 3.35/17.18로 개선됐다고 밝혔습니다. 벤더 공표치이며 BibiGPT가 측정한 점수가 아닙니다.
더 저렴한 옴니 API는 이미 Alibaba Cloud를 붙인 팀에 도움이 됩니다. 그것만으로는 학생이 2시간 Bilibili 업로드나 스탠드업 녹음에서 타임스탬프 노트를 바로 받을 수는 없습니다. 후반은 BibiGPT 제품 영역입니다.
링크를 붙이면 챕터·대본·후속 Q&A를 받습니다. BibiGPT는 긴 콘텐츠 노트에 Qwen3.8 Omni Flash를 지원합니다 — 옴니 조합을 고를 필요가 없습니다.
오디오와 영상이 모델에 들어가는 건 유용합니다. 90분 회의에는 여전히 타임스탬프와 내보내기가 필요합니다. 싼 API 한 번으로 챕터를 안 만들면 헛돈입니다 — 챕터 있는 요약이 다음 주에도 검색되는 문서입니다.
Qwen3.8-Flash는 8월 텍스트/멀티모달 MoE입니다. Gemini 3.8 Flash는 같은 시기 Google의 오디오·영상 대조입니다. Qwen3-ASR은 음성 인식입니다. 이 페이지는 2026-09-18 Omni-Flash 이벤트만 다룹니다. 한 의도, 한 URL.
Qwen 2026-09-18 Qwen3.8-Omni-Flash 발표의 핵심 사실.
Qwen은 당일 Qwen AI와 Alibaba Cloud Model Studio에 Qwen3.8-Omni-Flash(API 이름 qwen3.8-omni-flash)를 올렸습니다. 호스팅 옴니 SKU이며 오픈소스 Flash-Next 가중치 배포가 아닙니다.
한 모델이 네 입력을 받아 텍스트를 씁니다. Qwen3.8-Flash(텍스트 멀티모달 MoE)나 Qwen3-ASR(음성 인식)과는 다른 일입니다.
Qwen 문서는 100만 단위 창을 명시합니다. LiteLLM 당일 글은 최대 출력 131K를 적습니다. 긴 회의는 한 번에 넣을 수 있지만 호출 후에도 챕터는 필요합니다.
Qwen은 30개 벤치 평균 +26%, AliMeeting DER/cpWER 88.11/89.61 → 3.35/17.18, 오디오·영상 점수는 Gemini 3.8 Flash에 가깝다고 밝혔습니다. 벤더 숫자를 전달합니다.
LiteLLM은 입력 $0.15, 캐시 $0.016, 출력 $0.47, 영상 입력이 Qwen3.5-Omni-Plus 대비 약 89% 저렴하다고 적습니다. 예산 전 Model Studio에서 확인하세요.
네이티브 옴니 Qwen SKU가 중요한 곳 — 그리고 요약기가 진짜 제품 자리인 이유.
자체 스택에서 Qwen3.8-Omni-Flash로 옴니 이해를 씁니다. 끝난 강의나 스탠드업은 BibiGPT에 붙여 생 텍스트 덩어리가 아니라 챕터를 넘깁니다.
2시간 Bilibili 업로드나 스탠드업 녹음에 옴니 API 브리핑은 필요 없습니다. URL 붙이고, 대본 내보내고, 이어서 질문. 그게 BibiGPT 경로입니다.
Qwen3.8-Flash는 8월 텍스트 MoE. Qwen3-ASR은 음성 인식. Gemini 3.8 Flash는 Google 오디오·영상 대조. 이 페이지는 Omni-Flash만. 한 모델 패밀리 이벤트, 한 URL.
이번 공개에 맞춘 회의·장편 영상 노트 워크플로.
이 페이지 사양은 Qwen 2026-09-18 공지와 LiteLLM 당일 글에 기반합니다.
Qwen은 2026-09-18 Qwen3.8-Omni-Flash를 공개: 네이티브 옴니(텍스트/이미지/오디오/영상→텍스트), 1M 컨텍스트, Qwen AI·Alibaba Cloud Model Studio 제공. Qwen3.5-Omni-Plus 대비 30개 벤치 평균 +26%, AliMeeting DER/cpWER 88.11/89.61 → 3.35/17.18이라 Qwen이 밝혔습니다.
Qwen — Qwen3.8-Omni-Flash ↗LiteLLM 2026-09-18 글은 API 이름 qwen3.8-omni-flash, 1M 컨텍스트, 최대 출력 131K, 국제가 100만 단위 입력 $0.15/캐시 $0.016/출력 $0.47, 영상 입력이 Qwen3.5-Omni-Plus 대비 약 89% 저렴하다고 적습니다.
LiteLLM — Qwen3.8-Omni-Flash day-0 ↗네이티브 옴니 모델은 같은 스택 안에서 여러 매체 — 여기서는 텍스트·이미지·오디오·영상 — 를 받아 하나의 텍스트 응답을 씁니다. 「먼저 ASR, 그다음 텍스트 모델」 직렬이 아닙니다. 문서상 Qwen3.8-Omni-Flash가 이런 스택입니다.
100만 단위 창은 원칙상 한 호출에 긴 대본과 지시를 넣을 수 있습니다. 그 자체로 챕터·타임스탬프·다음 주 검색 가능한 내보내기를 만들지 않습니다. 그 산출물은 노트 제품의 일입니다.
매일 영상을 텍스트로 바꾸는 데 BibiGPT가 선택받는 이유.
전 세계 50,000명 이상이 신뢰하는 서비스
“링크만 붙여넣으면 몇 초 만에 깔끔한 자막 텍스트가 나와서 매주 몇 시간씩 걸리던 받아쓰기가 사라졌어요.”
Maya R.
콘텐츠 크리에이터 · 숏폼 영상 재활용
“스크립트를 내보낼 수 있어서 영상을 계속 멈추지 않고 제 속도로 새 단어를 복습할 수 있습니다.”
Daniel K.
어학 학습자 · 실제 영상으로 공부
“타임스탬프가 달린 정확한 텍스트를 바로 인용할 수 있어요. 어느새 매일 쓰는 워크플로의 일부가 됐습니다.”
Priya S.
연구원 · 공개 강연 인용
FAQ
무엇이든 물어보세요!
 1
DeepSeek Harness에 영상 요약 skill을 넣는 건 디렉터리를 복사하면 끝——SKILL.md는 Claude Code와 같습니다. dsh 없이 브라우저에 Bilibili나 YouTube 링크만 붙여도 타임스탬프 요약이 나옵니다.
 2
2026년 최고의 Bilibili AI 동영상 요약 도구는? 링크를 붙여넣으면 30개 이상 플랫폼에서 구조화된 요약, 마인드맵, 핵심 포인트를 즉시 받을 수 있습니다. 상위 5개 도구를 비교합니다.
 3
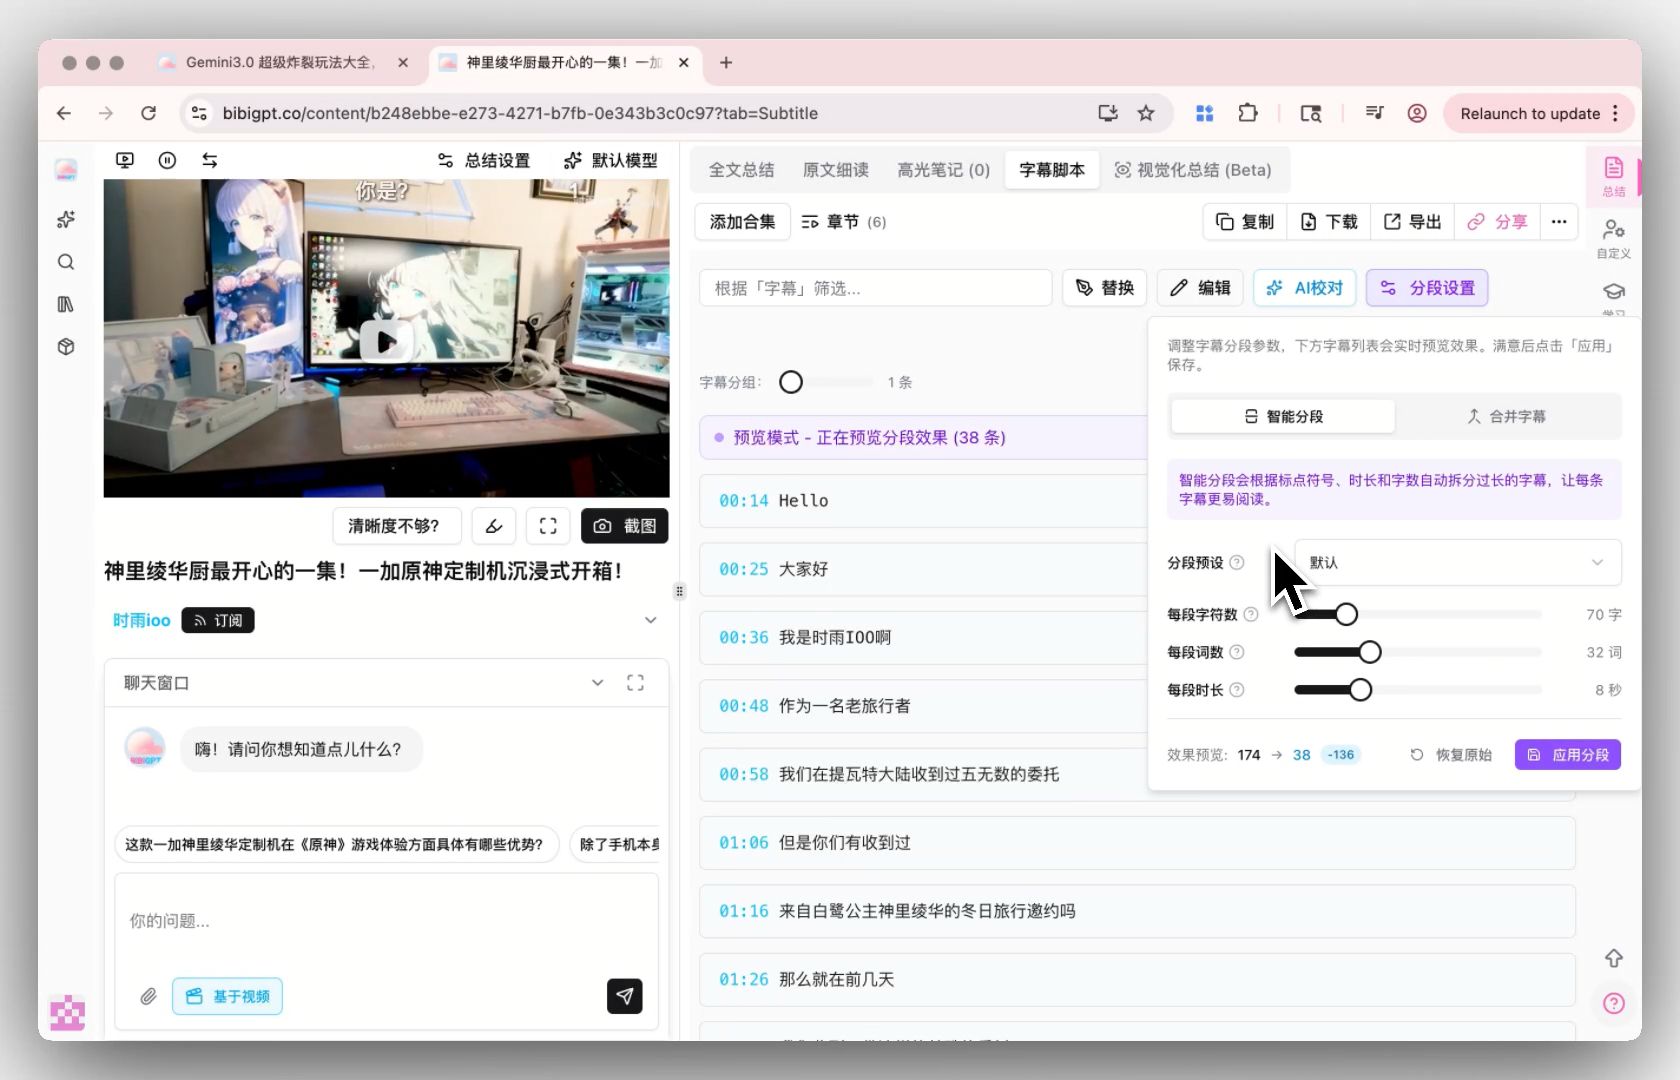
Bilibili 영상에서 자막을 추출하는 최고의 방법은? 5가지 주요 bilibili transcript 도구를 비교 분석하고, BibiGPT가 AI 전사, 번역, 요약 기능으로 어떻게 차별화되는지 알아보세요.
YouTube·Bilibili·팟캐스트·회의 링크 하나면 유튜브 요약과 같은 흐름으로 챕터·대본·후속 Q&A를 받을 수 있습니다. 최종 업데이트: 2026-09-26.