GPT-Transcribe vs Whisper vs Grok Voice 2.0 vs MAI-Transcribe:2026 语音转文字模型怎么选

你刚录完两小时访谈,文件还在导出。打开转写界面,候选模型已经不是去年那一个「大家都用 Whisper」。OpenAI 把文件转写的推荐模型改成了 GPT-Transcribe,实时路径改成 GPT-Live-Transcribe;xAI 把 Grok Voice Transcribe 2.0 放到同一条语音转文字接口上;微软的 MAI-Transcribe-1.5 则在多语言公开测试里把错误率压到很靠前。你真正要回答的不是「哪个名字最新」,而是这段音频该交给谁。
这已经不是「再下一个转写模型」的资讯题,而是一次选型:同一段会议、播客或课程,四家模型在价格、说话人标注、字幕时间戳和公开错误率上并不重合。选错的代价很具体——术语写错、说话人并成一个人、或者你要的 SRT 根本吐不出来。
多数文章会写成单模型通稿:发布日、跑分、一句「行业变了」。这篇反过来做:把 GPT-Transcribe、Whisper、Grok Voice Transcribe 2.0、MAI-Transcribe-1.5 放在同一张桌上,只比开发者和内容团队真正会卡住的那几项。
100 字直答: 截至 2026-09-21,文件转写优先看 GPT-Transcribe 或 Grok Voice Transcribe 2.0;要说话人分离且在乎单价,Grok Voice 2.0 更合适;要 43 种语言和企业词表,看 MAI-Transcribe-1.5。Whisper 还没关机,但只该留给字幕时间戳、SRT/VTT 和英译。模型给的是文字,链接进、带时间戳的成品出,是另一层工作。
目录
- 为什么 2026 年还要重新选语音转文字模型
- GPT-Transcribe 是什么,它和 Whisper 差在哪
- Grok Voice Transcribe 2.0 值不值得换
- MAI-Transcribe-1.5 适合谁
- 四模型对比表和场景决策
- 从模型到成品文稿的五步工作流
为什么 2026 年还要重新选语音转文字模型
Whisper 曾是默认答案,是因为接口稳、资料多、几乎任何语言都能先跑一版。2026 年这条默认路径断了:OpenAI 在 转录指南 里把文件转写的推荐模型改成 gpt-transcribe,把持续流入的麦克风音频改成 gpt-live-transcribe;同一份 弃用表 写明,whisper-1、gpt-4o-transcribe 等将在 2027-02-26 从 API 移除。继续把「Whisper」三个字当万能钥匙,会在关机日才发现字幕管线还钉着旧模型。
选型变贵,是因为公开数字第一次能并排看。据 Artificial Analysis 语音转文字榜(AA-WER v2,越低越好):GPT Transcribe 约 3.3%,Grok Voice Transcribe 2.0 约 2.3%,MAI-Transcribe-1.5 约 2.4%,OpenAI 托管的 Whisper Large v2 约 4.1%。这不是「谁发了新闻稿」,而是同一套公开测试把错误率摊开。Microsoft 在 MAI-Transcribe-1.5 发布说明 里还给出另一组口径:FLEURS 43 语平均词错误率做到该榜当时最低,Artificial Analysis 上报 2.4%、当时第 3 名。
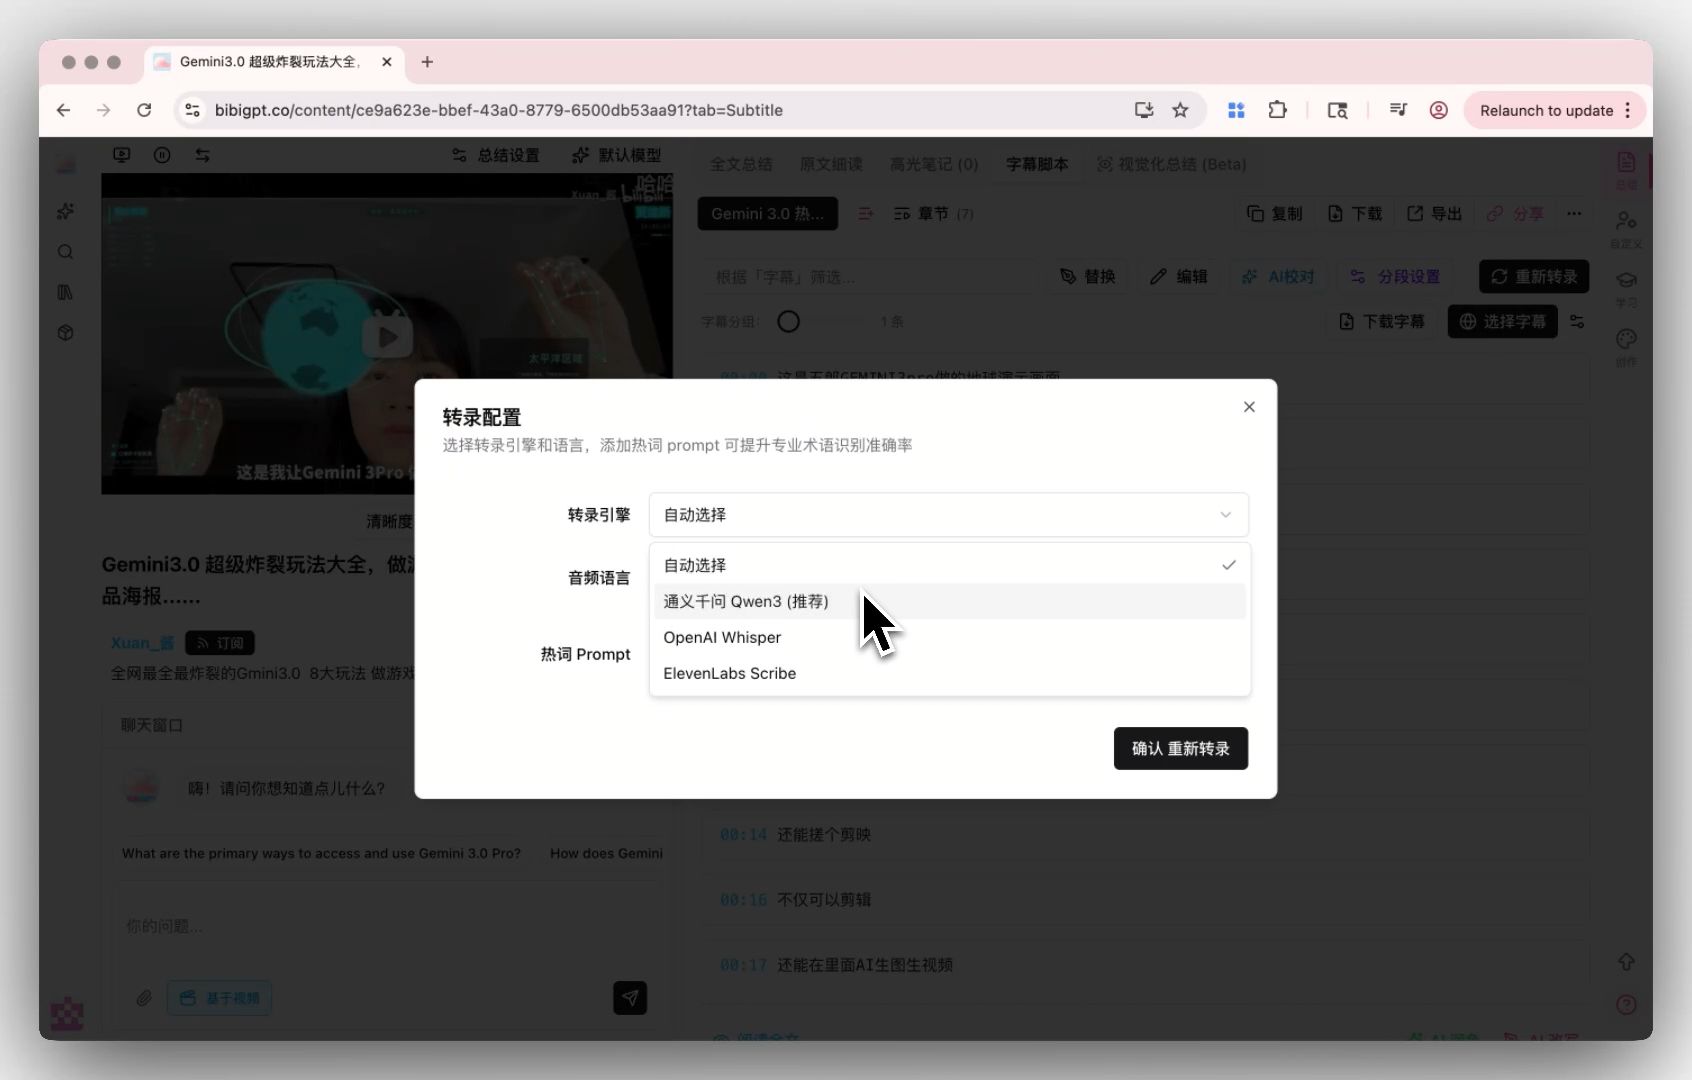
下面这张图帮助把「模型」放回它该在的位置:它只负责音频进、文字出。外面还要包下载、分段、总结和导出——这才是大多数人实际要买的东西。
来源:BibiGPT 自定义转录引擎功能页
实用规则: 先问输入输出。输入是裸音频、输出是裸文字,那是引擎;只有输入能是一条链接、输出能是可检索的文稿,那才是工具。
价格也已经拆开,不能再用「转写都很贵」糊弄过去。OpenAI 定价页 写明:gpt-transcribe 约每分钟 0.0045 美元(折合约每小时 0.27 美元),gpt-live-transcribe 约每分钟 0.017 美元。xAI 给 Grok Voice Transcribe 2.0 的标价是批量每小时 0.10 美元、流式每小时 0.20 美元。微软给 MAI-Transcribe-1.5 的公开价是每小时 0.36 美元。同一小时音频,三家差出三倍以上——这才是该重新选的理由。
GPT-Transcribe 是什么,它和 Whisper 差在哪
GPT-Transcribe 是 OpenAI 给「已经录完的文件」准备的推荐转写模型,不是 Whisper 换了皮。官方迁移说明把它和 GPT-Live-Transcribe 拆成两条路:文件走 POST /v1/audio/transcriptions 的 gpt-transcribe;持续流入的直播、字幕、麦克风走 gpt-live-transcribe。Whisper 还在,但职责被收窄:要词级时间戳、要 SRT/VTT、要把整段录音译成英文,官方仍指向 whisper-1。
适用场景很清楚:
- 会议回放、播客成片、课程录像——文件已经在手里,可以等完整稿
- 需要语言检测、关键词提示、领域词表,而不是一份死字幕格式
- 现有集成还在用
whisper-1,但可以先把「普通转写」迁走,把字幕管线留到最后
文件转写的日常入口,往往是「一条链接或一个已导出的成片」,而不是先在终端里拼 multipart。下面这张图是成品工具里粘贴链接的那一步——模型还没出场,输入层已经决定你能不能用上它。
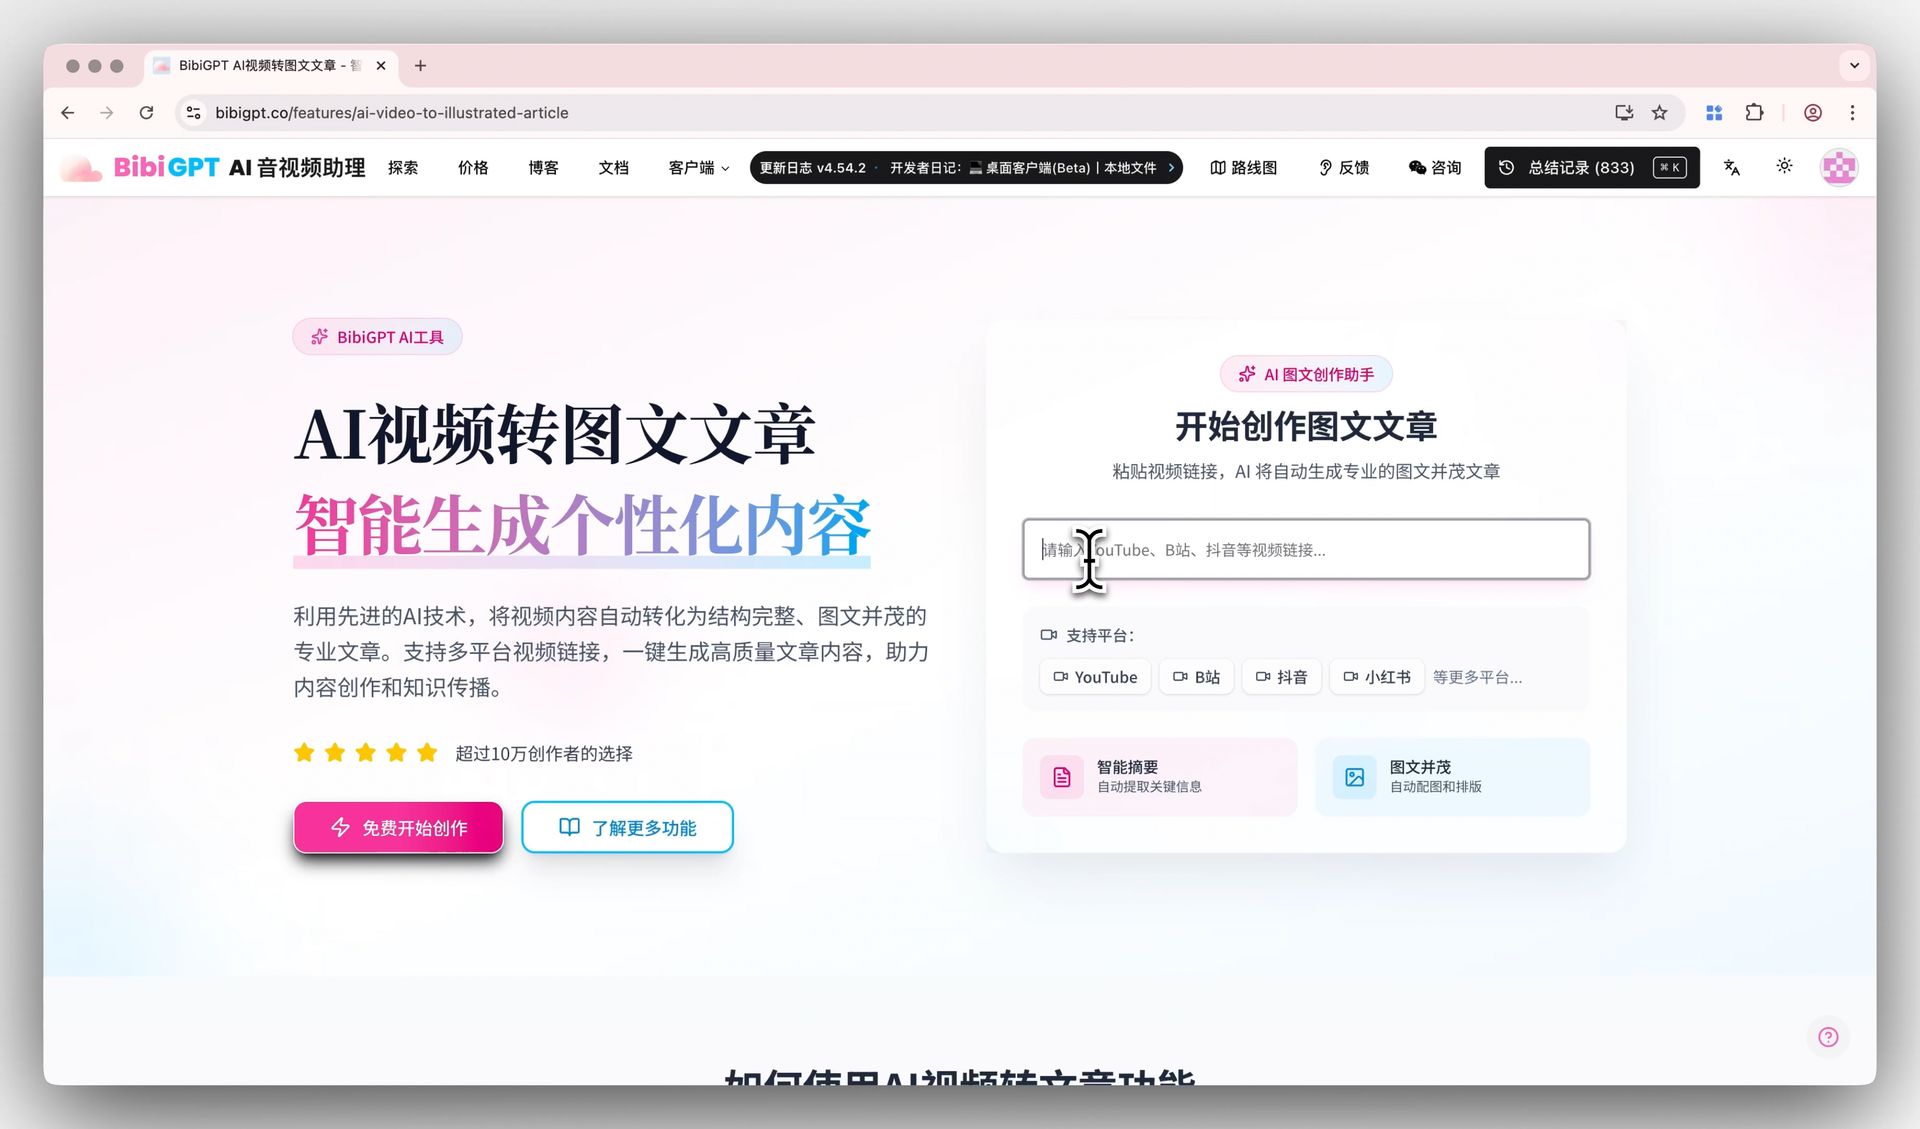
来源:BibiGPT 视频转图文输入演示
不适合的时候同样清楚:你要的是带轴的字幕文件,或说话人标签。说话人分离在 OpenAI 一侧仍是另一条模型 ID(gpt-4o-transcribe-diarize),而这条也被写进 2027-02-26 的移除名单;SRT/VTT 仍在 Whisper。把 GPT-Transcribe 当成「Whisper 的超集」会在导出字幕那天踩空。
下面是一条可执行的迁移顺序,专给已经把 Whisper 写进生产的人:
- 列出所有调用
whisper-1的地方,按「只要文字」和「要字幕/时间戳/英译」分成两堆。 - 「只要文字」的文件转写,改
model=gpt-transcribe,把原来的单数language改成languages数组。 - 领域词(产品名、药名、人名)放进
keywords,上下文说明放进prompt,不要再塞满 Whisper 那 224 token 的提示窗。 - 直播字幕、边说边出字,改走
gpt-live-transcribe,不要用文件模型硬扛实时。 - 仍要 SRT/VTT 或词级时间戳的管道,暂时留在
whisper-1,并在日历上标 2027-02-26。 - 用同一段 10 分钟真实录音做 A/B:术语、数字、口头禅各抽 20 处,不要只看官方示例。
- 迁移完成后再删旧模型开关,避免「一半流量已经在新模型、字幕导出还在旧模型」。
OpenAI 自己用一段演示讲清「文件模型」和「直播模型」的分工。看完再决定你的管线要拆几条,比先改 SDK 更省事。
视频来源:YouTube · Introducing gpt-transcribe and gpt-live-transcribe
实用规则: Whisper 不是立刻消失,它是被降级成「字幕和英译专用件」。普通转写先迁 GPT-Transcribe;字幕轴、词级时间戳、英译,等官方给出替代方案再动。
Grok Voice Transcribe 2.0 值不值得换
Grok Voice Transcribe 2.0 是 xAI 在 2026-09-18 放到 Speech-to-Text API 上的新转写模型,官方口径是:比 1.0 大约准一倍,价格不变。批量仍是每小时 0.10 美元,流式每小时 0.20 美元,说话人分离、词级时间戳和最多 100 个关键术语都包在标价里。这和「发布一个更贵的旗舰」不是同一类动作。
据 xAI 发布说明,它针对的是脏音频:通话噪声、抢话、口音、读出来的邮箱和卡号。官方还写:在 Artificial Analysis 的流式模型准确率榜上,2.0 排在当时 32 个流式模型的第一。同一份说明里,短指令集(车载那种缺少上下文的短语)的词错误率从 1.0 的 20.6% 降到 6.8%。这些是官方评测,不是你自己的会议录音——但方向一致:1.0 已经能打,2.0 把多语言和脏音频当作主升级。
和 2026-07 那篇 Grok STT 1.0 解析 相比,这次不是「又一个引擎上市」,而是同价换准度。Artificial Analysis 非流式 AA-WER 把 2.0 记在约 2.3%,1.0 约 4.0%。如果你已经在用 1.0,官方说现有 /v1/stt 集成可以无代码吃到准确率提升;过渡期若必须钉住旧版,显式指定 grok-voice-transcribe-1.0。1.0 会在随后几周弃用。
下面这张入口图,对应的是「用户能看见并切换的转写供应商」,不是某一家模型的绑定承诺。引擎可以换,成品链路还是那一套。
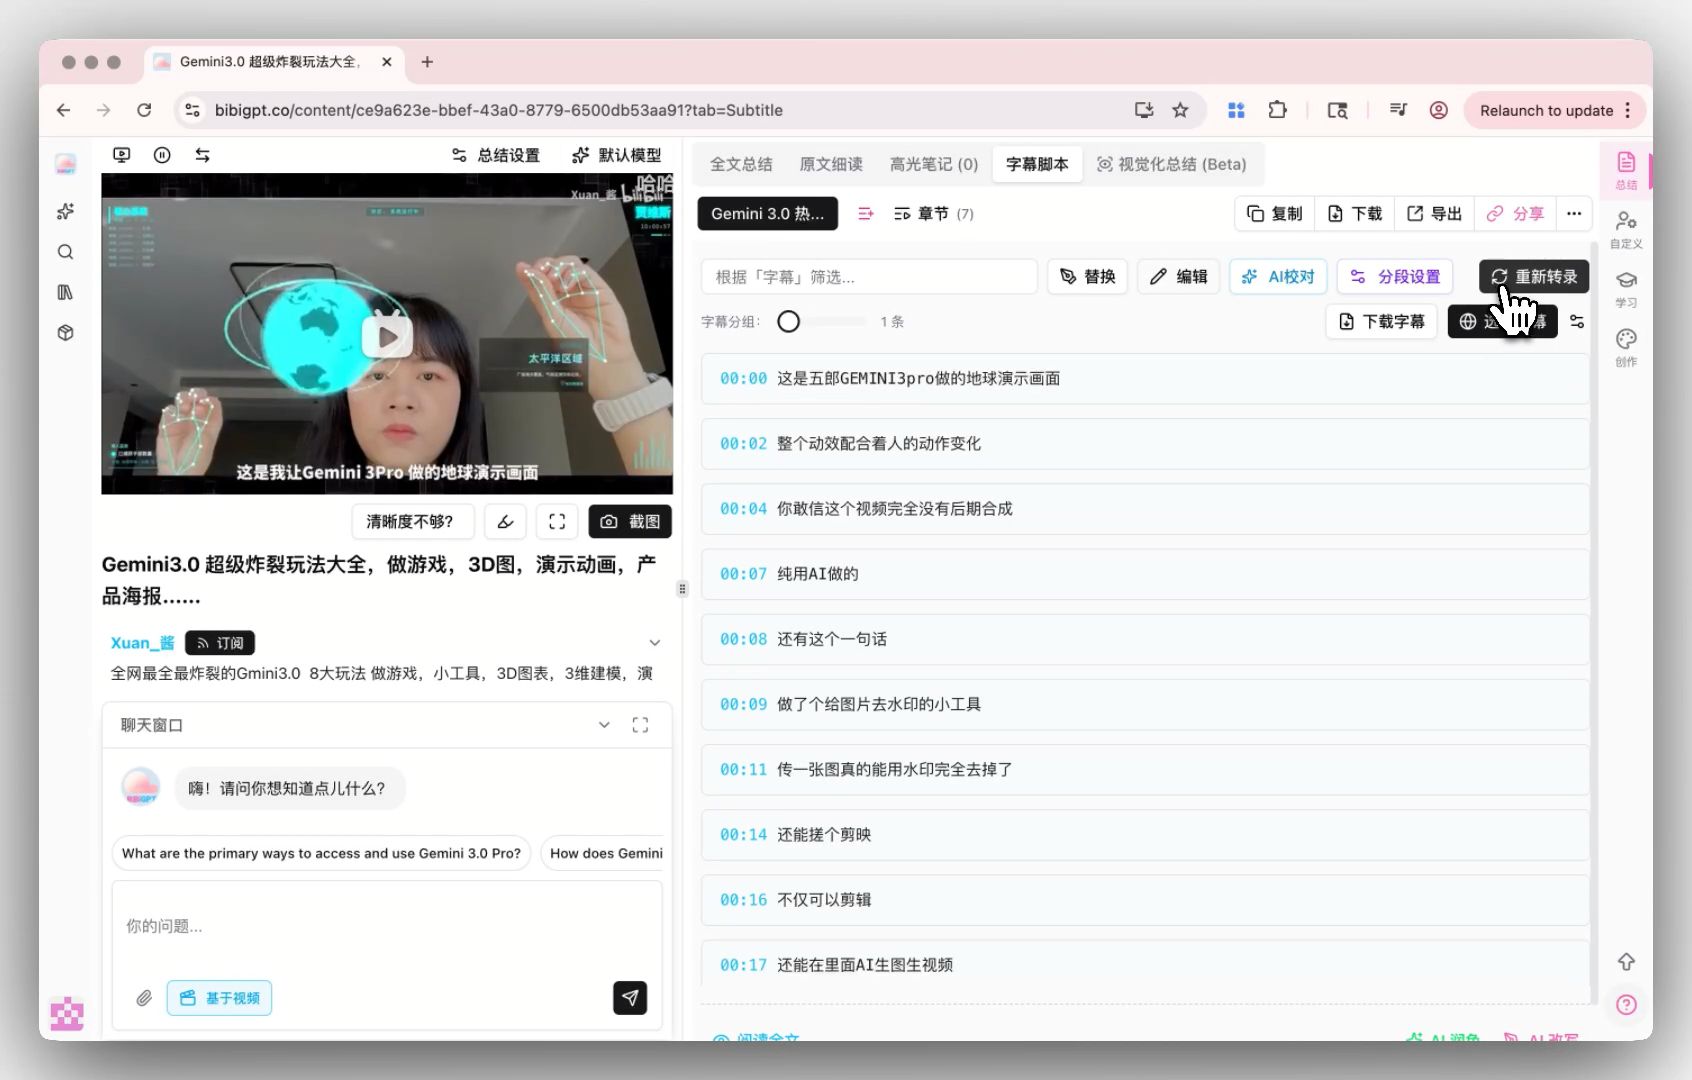
来源:BibiGPT 自定义转录引擎入口
实用规则: Grok Voice 2.0 适合「要说话人 + 要时间戳 + 要压单价」的开发者。它仍然是引擎:音频进、文字出。你不会因为换成 2.0,就自动得到播客章节和可跳转的摘要。
MAI-Transcribe-1.5 适合谁
MAI-Transcribe-1.5 是微软 AI 团队 2026-06-02 发布的多语言语音转文字模型,语言覆盖从 1.0 的 25 种扩到 43 种,公开价每小时 0.36 美元。它不是「又一个通用转写」,而是一条偏企业生产的路径:词表偏置、可读稿/逐字稿两种风格、走 Azure Speech 的 LLM Speech API。据 Azure 文档,mai-transcribe-1 已在 2026-08-20 弃用,新集成应直接钉 mai-transcribe-1.5。
官方强调三件事。第一,速度:一小时音频可在不到 15 秒内转完,发布说明称长音频可比 Gemini 3.1、Scribe v2、GPT-4o-Transcribe 快到约 5 倍。第二,词表:用户提供领域关键词后,模型按上下文决定何时偏置,官方称 FLEURS 上词错误率最多降约 30%。第三,短板写得很干脆——当前版本不支持说话人分离,也还没有原生流式 API,这两项被放在后续路线图。
所以它适合谁:多语言内容工厂、客服质检、字幕可读性优先、可以接受「先出一篇干净稿、说话人以后再加」的团队。它不适合:你必须在稿子上标「甲/乙」,或者必须边说边出字。我们更早写过 MAI-Transcribe-1 评测,1.5 的增量就是语言变多、词表可用、1.0 已被官方标成弃用。不要把 1.0 的 25 语口径继续抄进新方案。
智能分段解决的是另一头:模型吐出的长段落,怎样变成能读的字幕块。这和「哪个模型更准」是两件事,但会决定你第二天还看不看得下去。
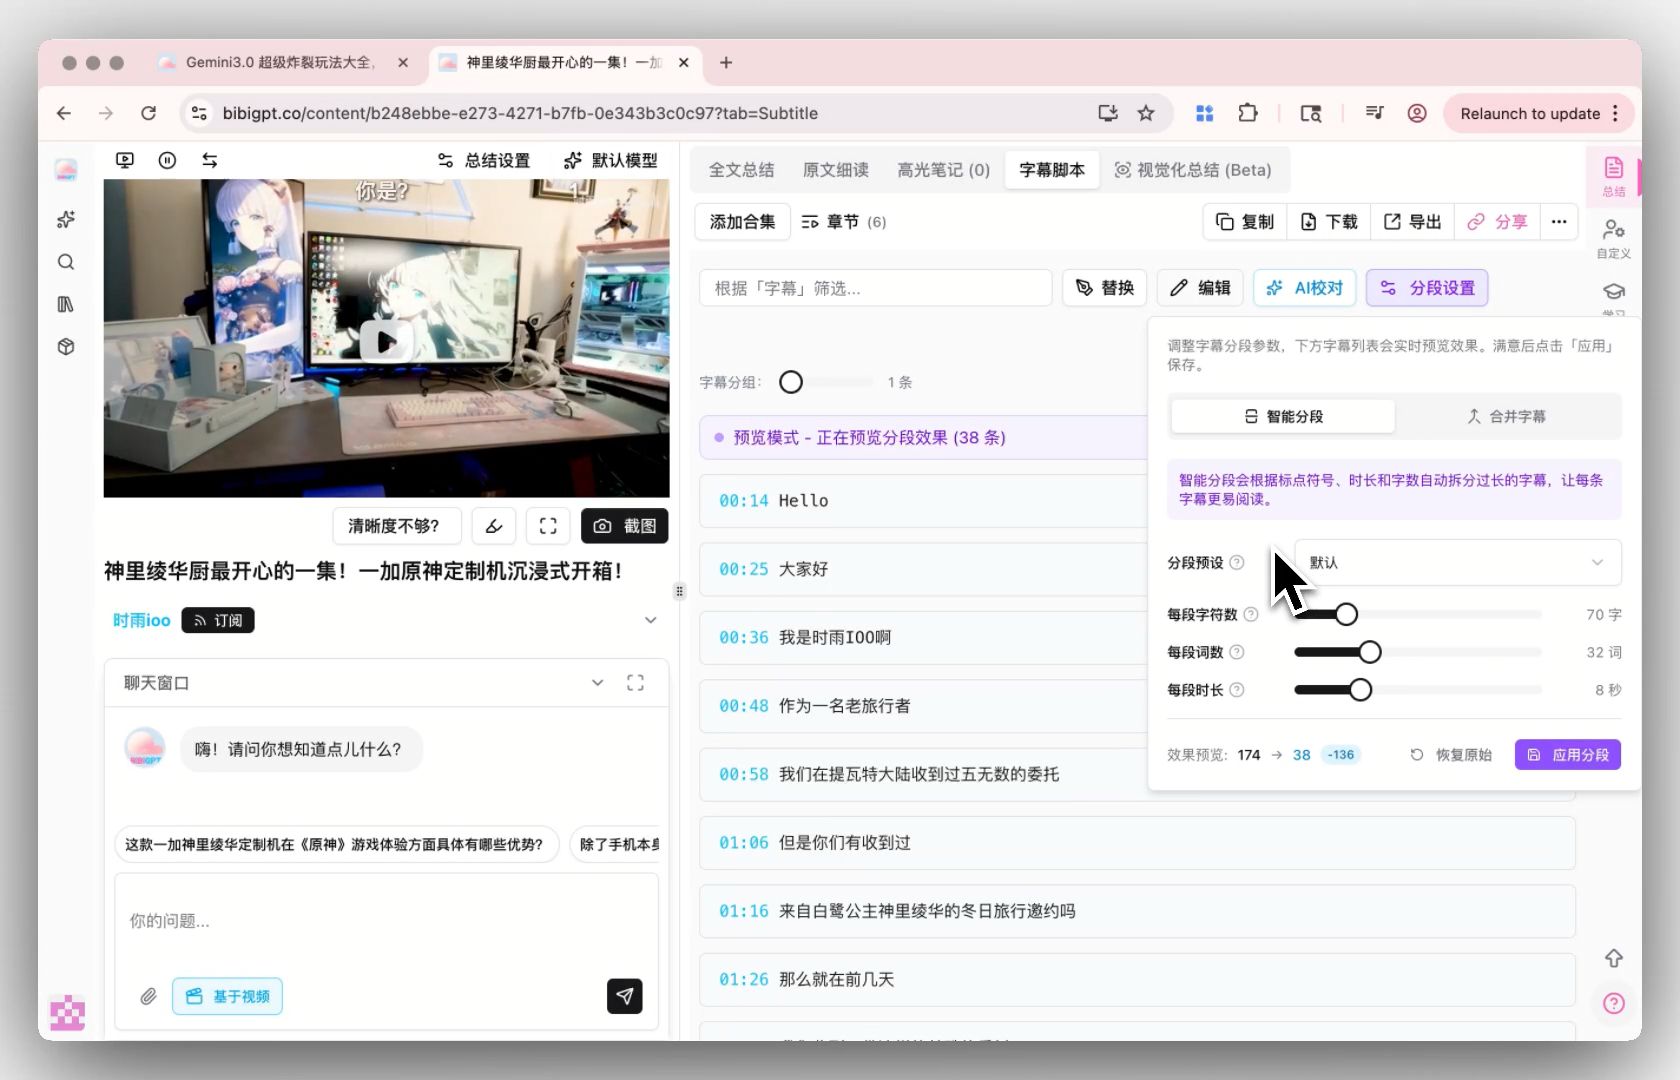
来源:BibiGPT 智能字幕分段功能页
实用规则: MAI-Transcribe-1.5 用「语言覆盖 + 词表 + 速度」换「暂无说话人、暂无原生流式」。会议纪要要分人,先不要把它当第一选择。
四模型对比表和场景决策
把公开规格摊开,比再写四段赞美更有用。下表数字来自 OpenAI 定价页、xAI 发布说明、微软发布说明,以及 Artificial Analysis 截至本稿的 AA-WER v2;同一指标请以各源页面为准,榜会变。
| 维度 | GPT-Transcribe | Grok Voice 2.0 | MAI-Transcribe-1.5 | Whisper-1 |
|---|---|---|---|---|
| 最适合谁 | 已有 OpenAI 文件转写、要迁出 Whisper 的团队 | 要说话人+时间戳、且在乎单价的开发者 | 多语言、企业词表、可读稿优先的生产环境 | 仍要 SRT/VTT、词级时间戳或英译的旧管道 |
| 公开错误率 | AA-WER 约 3.3% | AA-WER 约 2.3%;官方称流式榜当时第一 | AA-WER 约 2.4%;FLEURS 43 语官方称当时最低 | Whisper Large v2(OpenAI)AA-WER 约 4.1% |
| 标价 | 约 0.0045 美元/分钟(约 0.27 美元/小时) | 批量 0.10 美元/小时,流式 0.20 美元/小时 | 0.36 美元/小时 | 旧默认;2027-02-26 移除 |
| 说话人分离 | 需另走 diarize 模型(亦在弃用名单) | 包含,不另计费 | 当前不支持 | 非强项 |
| 字幕轴 / SRT | 官方仍指向 Whisper | 含词级时间戳 | 可读稿或逐字稿,不是 SRT 专用件 | 仍是官方字幕格式路径 |
决策可以压成三问,不必先跑完整基准:
- 你要的输出是「一篇可读稿」还是「一条字幕文件」? 字幕文件先留 Whisper;可读稿再在 GPT-Transcribe / Grok 2.0 / MAI-1.5 里选。
- 必须分清谁在说话吗? 必须,就优先 Grok Voice 2.0。MAI-1.5 现在做不到;OpenAI 的分人模型也在淘汰名单上。
- 音频是文件还是直播? 文件:GPT-Transcribe 或 Grok 批量;直播:GPT-Live-Transcribe 或 Grok 流式。MAI-1.5 仍是批量优先。
开源对照可以看 Parakeet vs Whisper:那是「能不能自己跑」的题,和本篇「2026 云端模型怎么选」不是同一张表。播客场景若还要工具层横评,再去 播客转写工具对比。
模型给的是一篇字。你第二天要的常常是一张能点开时间戳的知识地图——把一小时访谈压成一页,比再抠 0.2% 的 WER 更接近「用得上」。
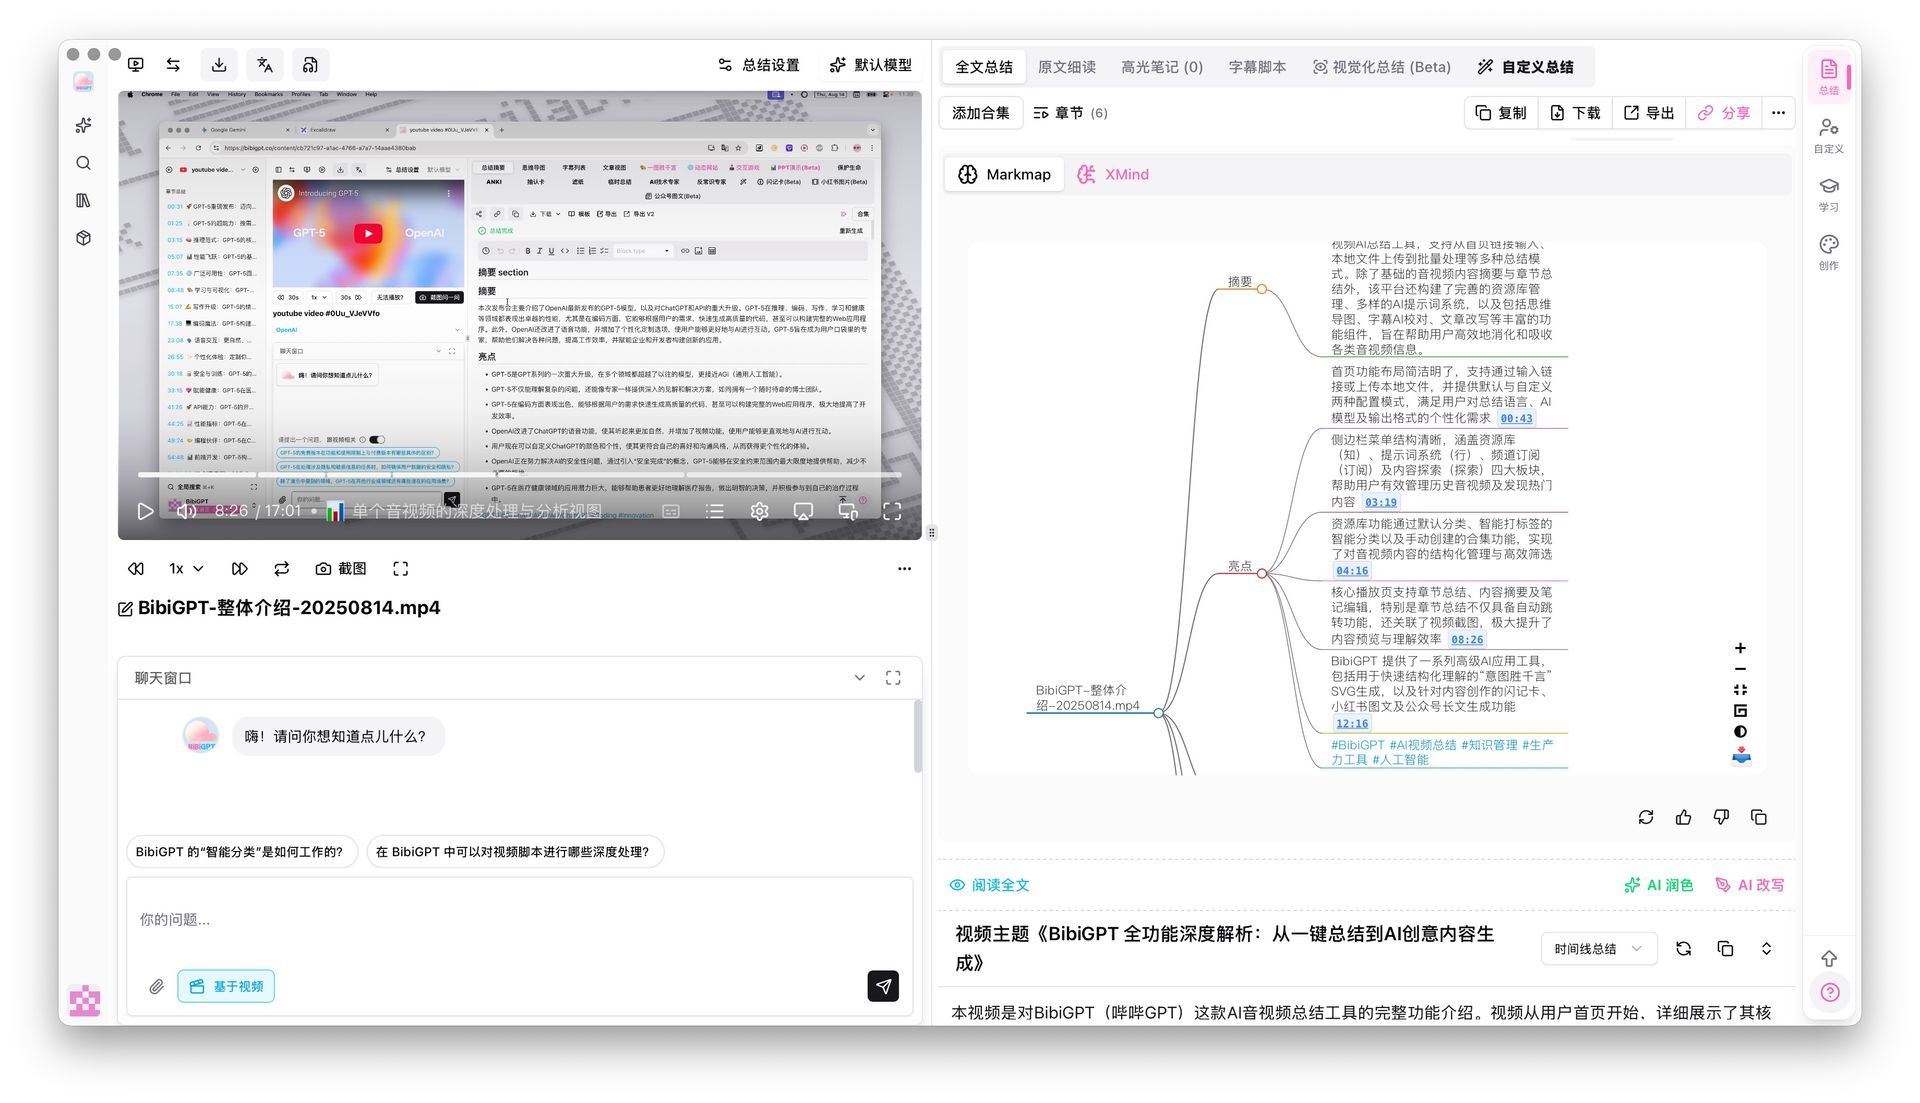
来源:BibiGPT 思维导图时间戳跳转功能页
实用规则: 先锁输出形态(稿 / 轴 / 分人),再锁预算,最后才看错误率小数点。把顺序倒过来,你会为 0.1% 的榜差换掉自己真正需要的字段。
选模型是开发者的题。如果你要的是「把一条视频或播客变成能读、能搜、能追问的文字」,模型只是中间那一截。下面可以直接试成品链路——粘贴链接,看带时间戳的总结长什么样。
几秒读完任何视频
选个样例,看 AI 总结——一句话结论、要点清单、可跳转的时间戳。
一句话: Karpathy 用代码从零搭出一个 GPT 风格的语言模型,逐行讲清每个部件——从最小的字符级模型到完整的 Transformer。
要点
- 先做一个 bigram 基线模型,再加自注意力,让 token 之间能"互相对话"
- 一个 Transformer 块 = 多头注意力 + 前馈网络 + 残差连接 + 层归一化
- 训练本质就是"预测下一个 token";剩下的交给规模和数据
- nanoGPT 背后的架构,放大后就是 ChatGPT
跳转
- 00:07 为什么要从零搭 GPT
- 08:23 直观理解自注意力
- 1:00:00 拼出 Transformer 块
- 1:35:00 从 nanoGPT 到 ChatGPT
从模型到成品文稿的五步工作流
模型选完,工作才开始。大多数人卡住的不是 WER,而是:链接还在浏览器里,文稿却要先下载、再切片、再贴进另一个对话框。把引擎嵌进成品链路,才是 2026 年值得升级的那一步。
一个能下周就用的流程:
- 固定输入: 会议用同一只录音位置,播客导出成片而不是直播流切片,避免把「模型不准」和「音源太差」混在一起。
- 按输出选模型: 只要文稿 → GPT-Transcribe 或 Grok 2.0;要分人 → Grok 2.0;要多语言词表 → MAI-1.5;要 SRT → 仍走 Whisper,并登记 2027-02-26。
- 把专有名词写成词表: 产品名、嘉宾名、缩写,每次请求都带上。Grok 的 key terms、OpenAI 的
keywords、MAI 的 phrase list,做的是同一件事。 - 抽检,不要只看第一页: 随机点开中间 10 分钟,核数字、人名、否定句。错误集中在这三类时,换模型往往比「再调一次 prompt」更有效。
- 把文稿变成可跳转的笔记: 章节、时间戳、导出格式比再低 0.2% 的 WER 更影响第二天能不能用。多格式导出是这一步的出口,不是装饰。
批量处理多条链接时,入口在资料库而不是每次重开一个 API 控制台。这是「引擎」和「成品工具」最容易被忽略的差别。
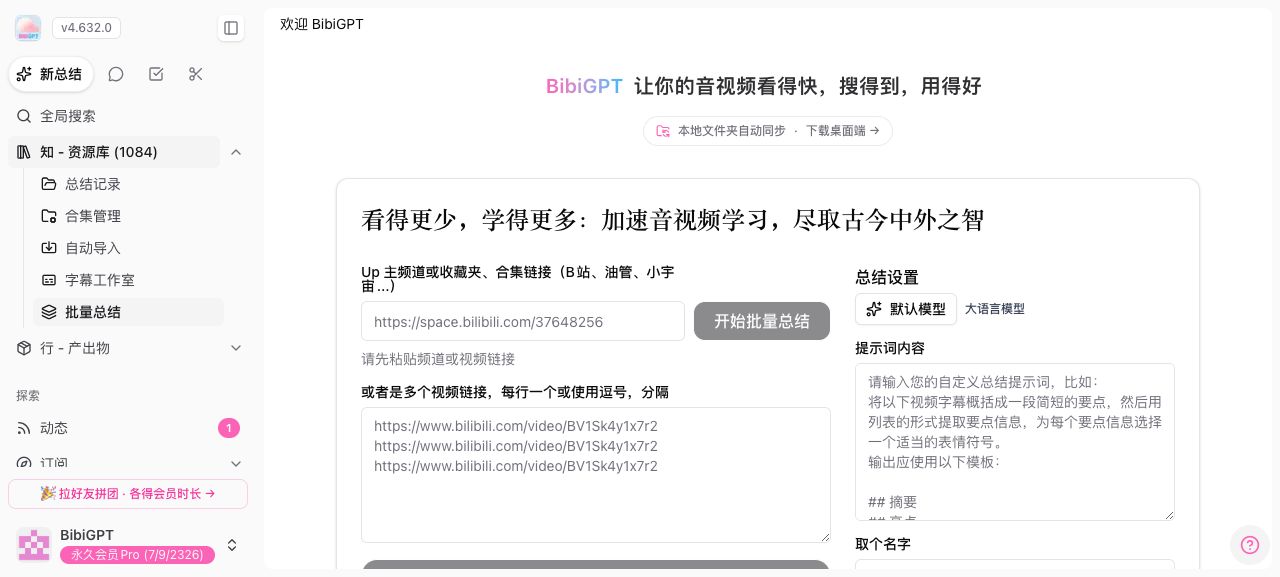
来源:BibiGPT 资料库批量总结入口
单条成片处理完,还要把稿子带走:Markdown、字幕轴、纯文本。导出格式决定你能不能把它丢进笔记软件,而不是停在浏览器标签里。
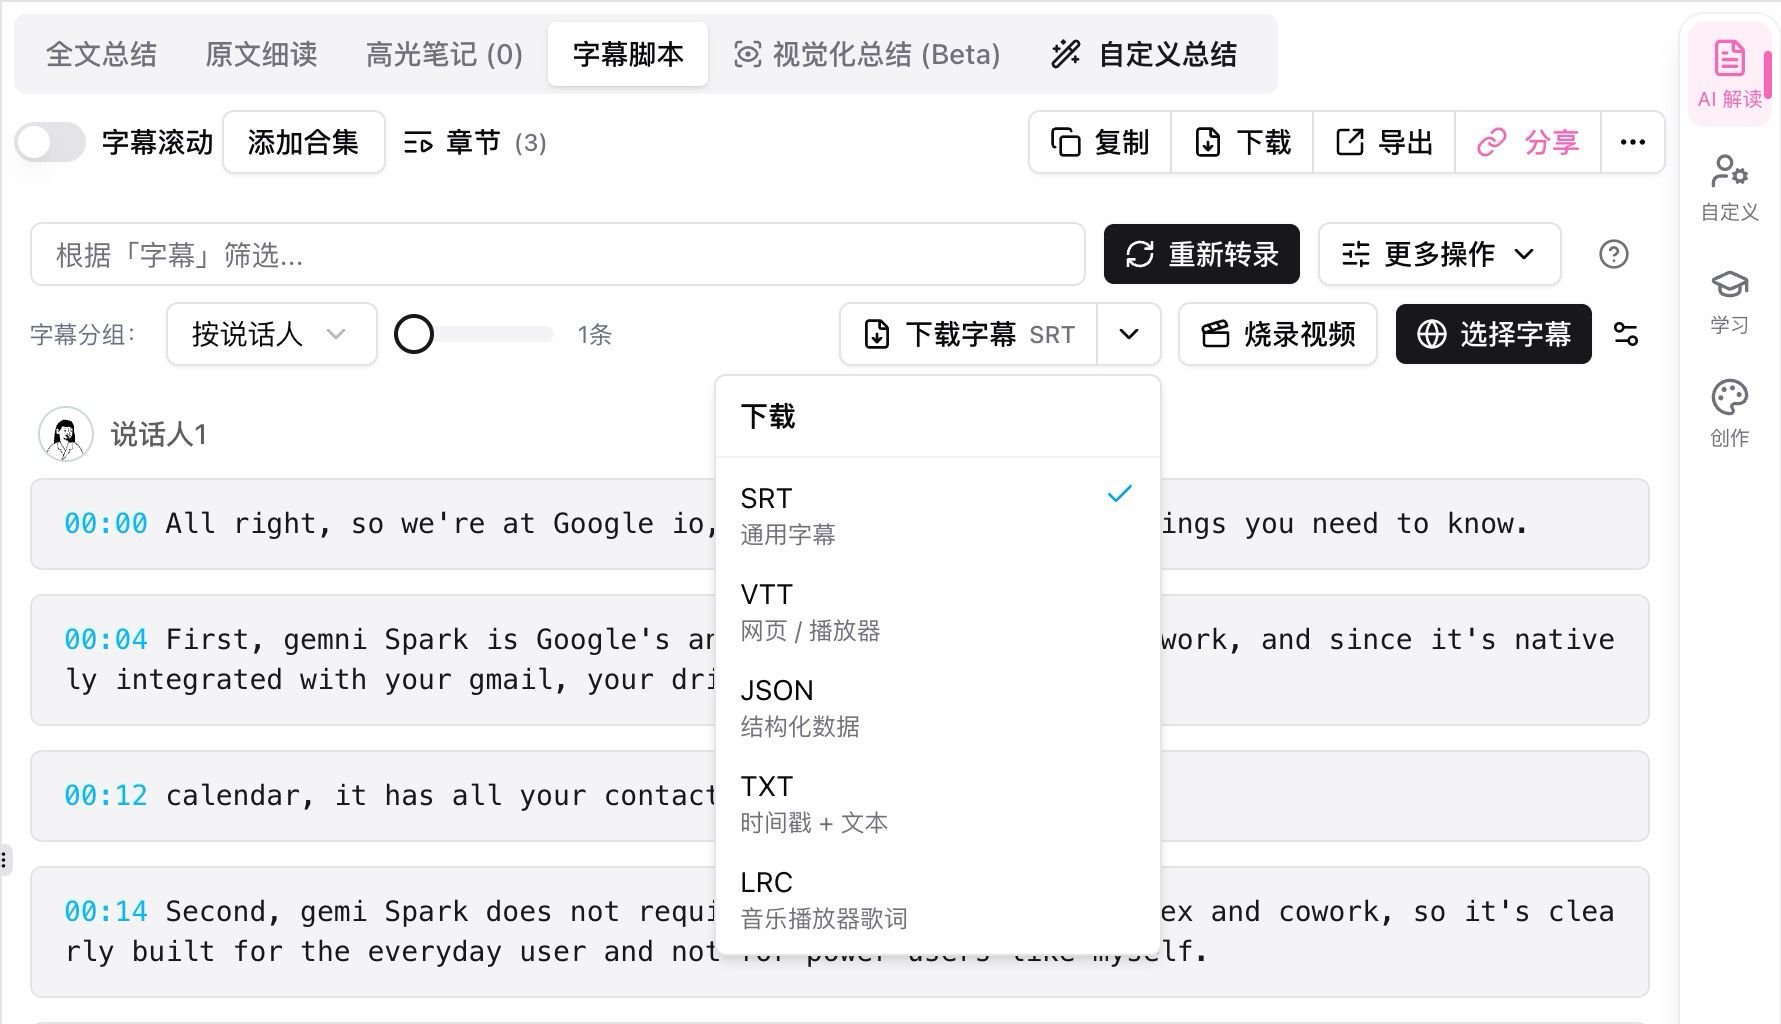
来源:BibiGPT 字幕多格式下载功能页
如果你没有自建转写管线,也不打算为一次播客去接三家 API,直接走成品工具更快:打开 在线语音转文字 或 自定义转写引擎,粘贴 B 站 / YouTube / 播客链接,拿带时间戳的文稿和总结。模型可以换,这条「链接进、笔记出」的路径不该每次重铺。
立即把音视频变成能用的文字:
- 🌐 官网: https://bibigpt.co/zh
- 📱 移动端下载: https://bibigpt.co/zh/app
- 💻 桌面端下载: https://bibigpt.co/zh/download/desktop
- ✨ 了解更多功能: https://bibigpt.co/zh/features
BibiGPT 团队
Popular tools
More in this series
- Apple iOS 27 Opens Third-Party AI: The Era of Switchable Assistants Is Here — How to Choose for Audio and Video (2026)
- DeepSeek R1 + BibiGPT: A Practical Guide to AI-Powered Audio/Video Understanding in 2025
- DeepSeek-V4 Is Here! BibiGPT Ships Four New Models + 1M Context on Day One — AI Video & Podcast Summarizing Just Leveled Up
- BibiGPT vs DeepSeek-V4 + Granite Speech Plus 2026: Self-Hosted Open Source vs Productized Stack
- Claude Opus 4.6 Agent Teams Are Here: How AI Agents Are Transforming Video Understanding with BibiGPT
View all 47 articles in Model Updates →